学习笔记,会随着学习继续修改,难免有不完整的地方。
Python 工程能力补齐|完整学习路线
1. Python 工程环境管理
1. 为什么需要虚拟环境?
假设你正在开发两个项目:
-
项目 A: AI Agent 服务,需要
pydantic 2.x。 -
项目 B: 旧版 Python 服务,需要
pydantic 1.x。
如果两个项目都向同一个 Python 环境安装依赖,就可能发生版本冲突。
比如,你为了项目 A 升级了 Pydantic,结果项目 B 的代码运行失败。
虚拟环境(Virtual Environment)就是为了解决这类问题。
它允许每个项目拥有自己的一套第三方依赖,不必相互干扰。
和 Docker 有什么区别?你之前已经学习过 Docker,所以可以直接比较:
| 对比 | venv | Docker |
|---|---|---|
| 隔离对象 | Python 环境及依赖 | 应用运行环境 |
| 是否隔离进程 | 否 | 是 |
| 是否隔离网络 | 否 | 通常是 |
| 是否包含操作系统环境 | 否 | 包含容器文件系统和用户空间 |
| 主要用途 | Python 项目依赖管理 | 应用打包与部署 |
可以简单理解:venv 负责 Python 依赖隔离,Docker 负责更大范围的运行环境隔离。
两者不是替代关系。
2. venv 的工作原理
当你执行:
python3 -m venv .venvPython 会创建一个目录,大致结构如下:
.venv/
├── bin/
│   ├── python-Python 解释器入口
│   ├── pip
│   └── activate-用户激活虚拟环境的 Shell 脚本
├── lib/
│   └── python3.x/
│       └── site-packages/-安装第三方依赖的位置
└── pyvenv.cfg
三个关键位置:
-
bin/python:虚拟环境中的 Python 解释器入口。 -
bin/activate:用于激活虚拟环境的 Shell 脚本。 -
site-packages:安装第三方依赖的位置。
这里有一个比较重要的原理:
激活虚拟环境,并不是启动一个新的 Python 进程,而是修改当前 Shell 的环境变量。
其中最关键的是 PATH。
例如,激活前:
PATH=/opt/homebrew/bin:/usr/bin:...激活后:
PATH=/项目路径/.venv/bin:
	 /opt/homebrew/bin:/usr/bin:...
由于 Shell 会按照 PATH 中的顺序查找命令,因此输入 python 时,就会优先找到虚拟环境中的解释器。
3. 练习
这次我们只创建环境、观察变化,不安装任何第三方依赖。
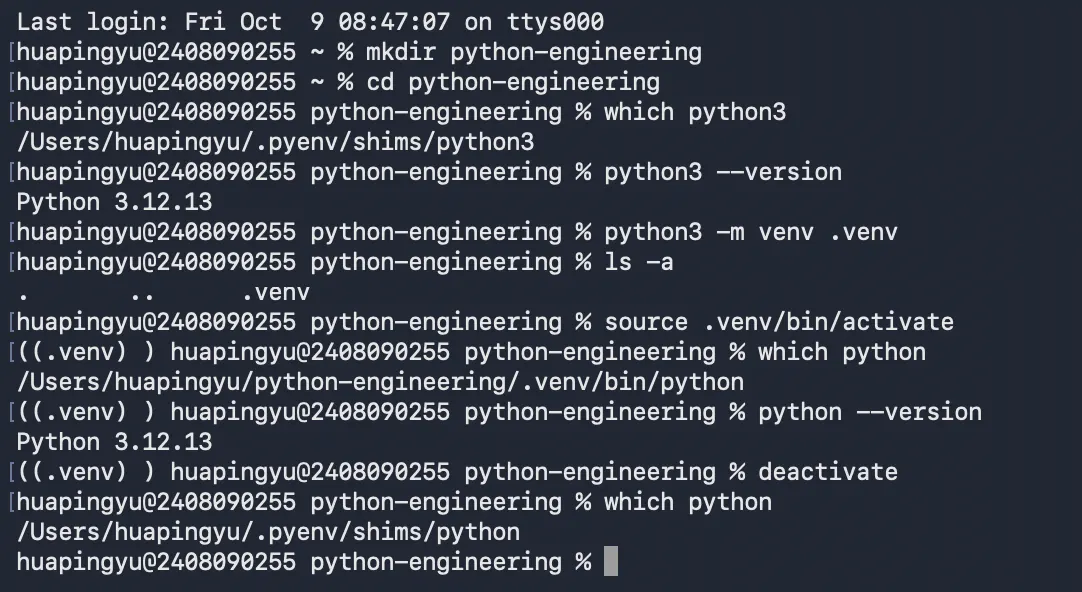
第一步:创建项目目录
打开 Mac 终端:
mkdir python-engineering
cd python-engineering
第二步:查看当前 Python
执行:
which python3
python3 --version
记录一下当前 Python 的位置。
第三步:创建虚拟环境
python3 -m venv .venv创建完成后,执行:
ls -a应该能看到 .venv。
第四步:激活虚拟环境
source .venv/bin/activate终端提示符通常会出现:
(.venv) huapingyu@Mac python-engineering %然后执行:
which python
python --version
此时 which python 应该指向:
.../python-engineering/.venv/bin/python第五步:退出虚拟环境
执行:
deactivate然后再次执行:
which python观察 Python 路径是否发生变化。
注意:退出后,如果系统找不到 python 命令,也不一定是错误。可以使用 which python3 查看系统当前可用的解释器。
4. 不激活虚拟环境,如果使用它?
假设你已经退出虚拟环境,但仍然想使用 .venv 中的 Python 运行 main.py,是否一定要先执行 source .venv/bin/activate?
刚才创建的虚拟环境中有一个 Python 解释器入口:
.venv/bin/python所以可以直接执行:
.venv/bin/python main.py甚至可以直接使用这个环境中的 pip:
.venv/bin/python -m pip list原理:
激活虚拟环境只是修改 PATH,让你输入 python 时自动找到 .venv/bin/python。
但如果你已经明确指定了这个路径,就不需要再修改 PATH。
可以理解为:
-
python main.py:让 Shell 根据PATH寻找 Python。 -
.venv/bin/python main.py:直接指定要使用哪个 Python。
5. 创建 & 激活虚拟环境的区别
创建虚拟环境和激活虚拟环境是两个独立的步骤。
创建后即使没有激活,虚拟环境也是可以正常使用的。
1. 两个步骤的区别
① 创建虚拟环境
python3 -m venv .venv作用:创建 .venv 目录,准备好独立的 Python 解释器入口和依赖安装位置。
② 激活虚拟环境
source .venv/bin/activate作用:修改当前 Shell 的 PATH,让你直接输入 python 时,优先使用 .venv 中的 Python。
二、创建后不激活,可以使用吗?
可以,而且有两种使用方式:
| 状态 | 执行命令 | 使用的 Python |
|---|---|---|
| 已创建,未激活 | python main.py |
当前 PATH 指向的 Python |
| 已创建,未激活 | .venv/bin/python main.py |
虚拟环境 Python |
| 已创建,已激活 | python main.py |
虚拟环境 Python |
所以,激活只是让使用虚拟环境变得方便,并不是使用它的必要条件。
你之前的报错:
can't open file 'main.py'恰恰说明虚拟环境的 Python 已经正常启动了,只是找不到要运行的文件。
三、记住一个核心区别
-
创建: 把虚拟环境准备好。
-
激活: 让当前终端默认使用这个虚拟环境。
-
直接指定路径: 不激活也能使用。
在实际开发中,我们通常会激活虚拟环境,方便反复执行命令;而在自动化脚本、部署等场景中,直接指定虚拟环境的 Python 路径也很常见。
6. 依赖管理
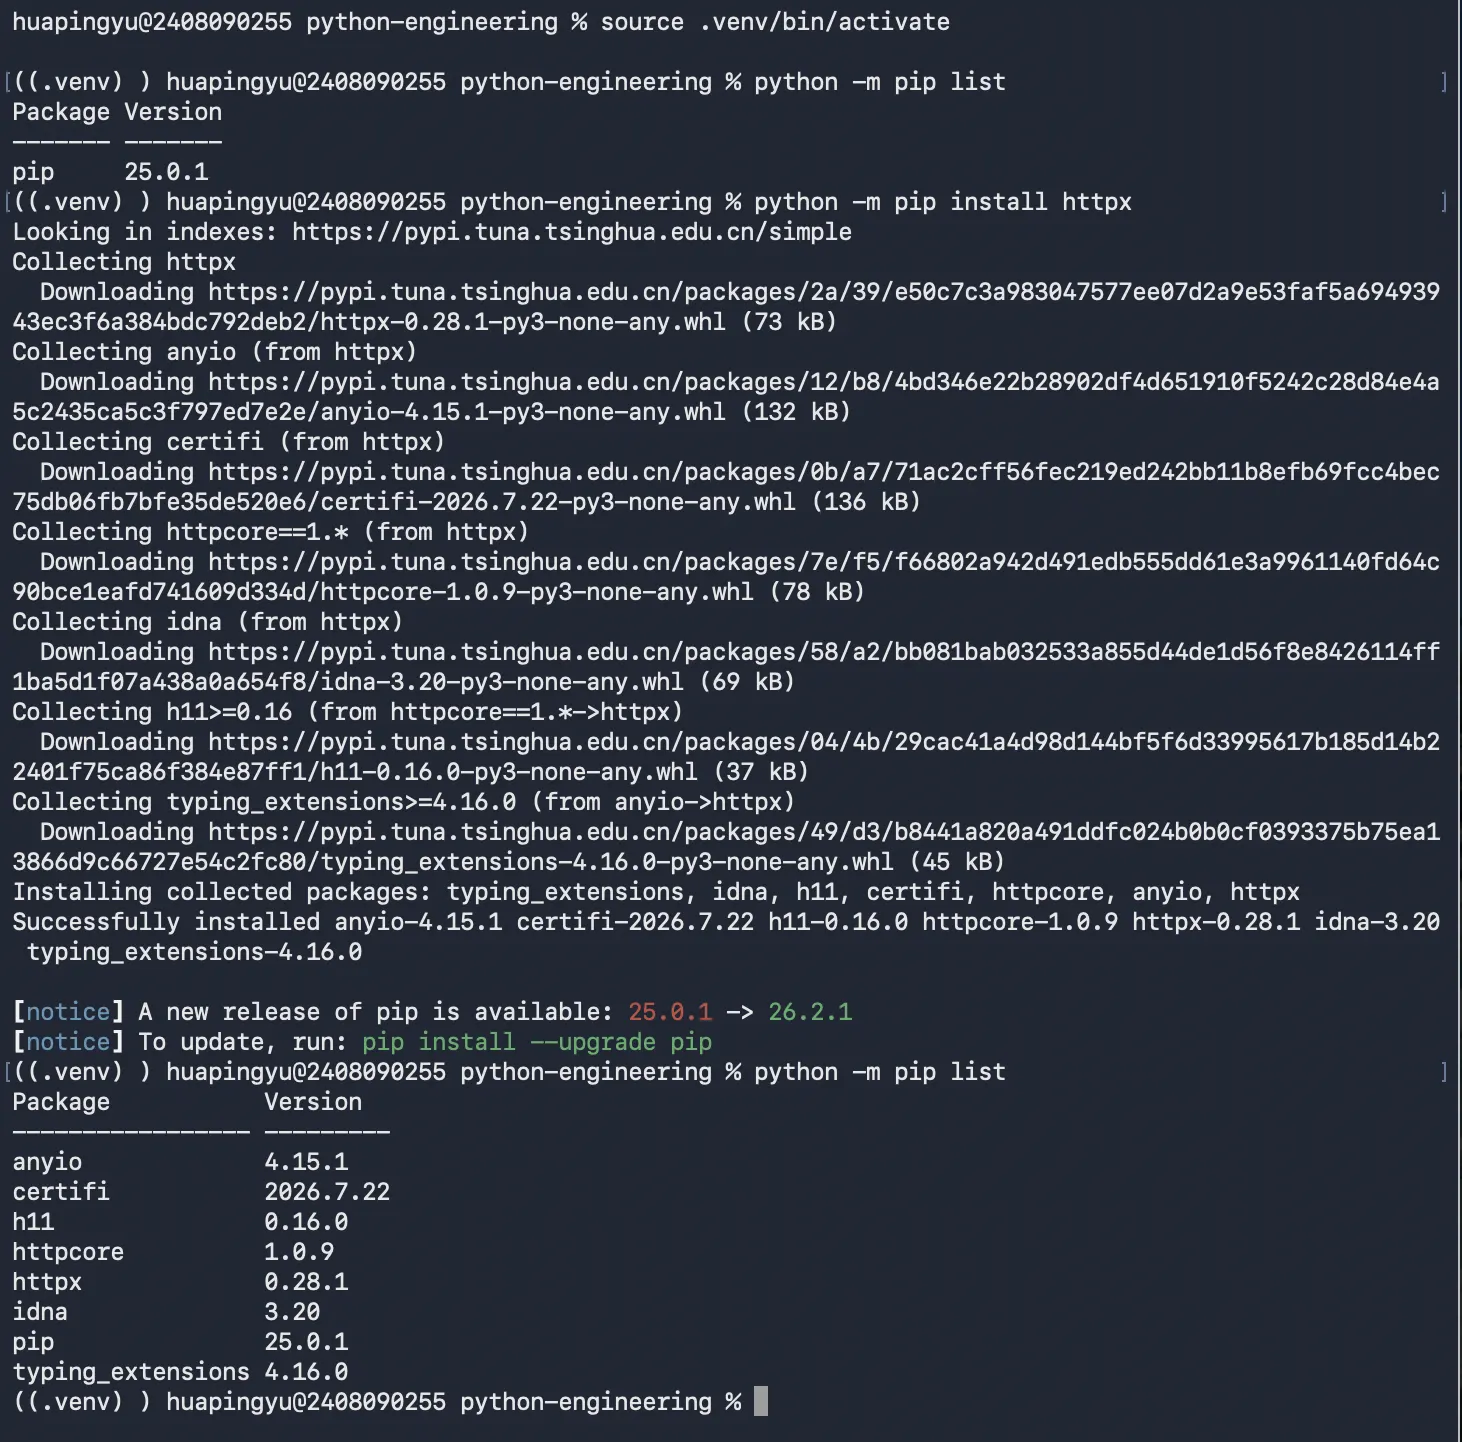
1. 为什么只安装 httpx,却出现了 7 个包?
执行的是:
python -m pip install httpx但实际上安装了:
httpx
├── anyio
│   ├── idna
│   └── typing_extensions
├── certifi
├── httpcore
│   └── h11
└── idna
因为 httpx 本身也依赖其他第三方库。
pip 会读取依赖声明,解析所需版本,并自动安装缺失的依赖。
2. 为什么推荐 python -m pip?
比较两条命令:
pip install httpxpython -m pip install httpx第一条:Shell 根据 PATH 查找 pip 可执行文件。
第二条:先确定使用哪个 python,再让这个解释器运行 pip 模块。
正常情况下,两者的效果相同。
但如果电脑上有多个 Python 环境,例如:
Python A → Python 3.11
Python B → Python 3.12
Python C → 项目虚拟环境
就可能出现:
你以为给 Python C 安装了依赖,实际却安装到了 Python B。
使用 python -m pip 能让安装行为明确绑定到当前指定的 Python 解释器。
不过要注意,它不能自动保证你选择的是正确的 Python;仍然需要确认 python 指向哪里。
3. 练习
我们验证 httpx 究竟安装在哪里。
目前还在虚拟环境中,执行:
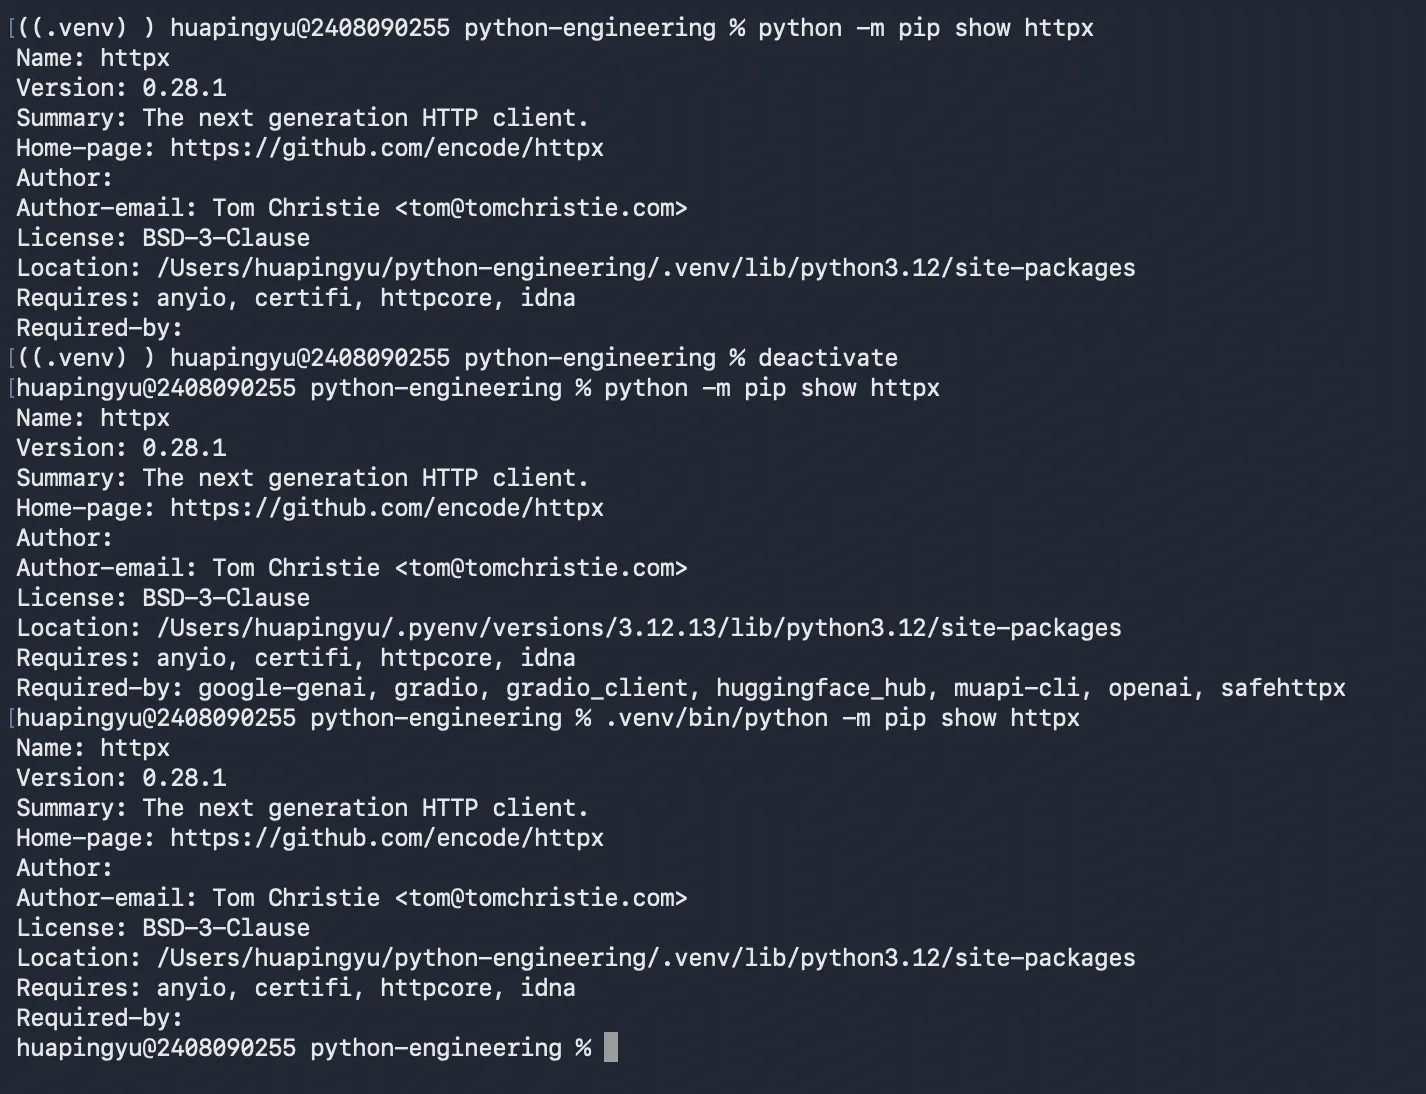
python -m pip show httpx重点观察 Location 字段。
然后退出虚拟环境:
deactivate分别执行:
python -m pip show httpx.venv/bin/python -m pip show httpx观察三次结果。
4. 虚拟环境隔离的到底是什么
退出虚拟环境后仍然能找到 httpx,是不是代表虚拟环境隔离失败了?
先说结论:虚拟环境隔离的是「依赖的安装位置」和「默认搜索范围」,而不是包的名称。
一、电脑上存在两个 Python 环境
环境 A:pyenv 管理的 Python 环境
/Users/huapingyu/.pyenv/versions/3.12.13/
└── lib/python3.12/site-packages/
    ├── httpx
    ├── openai
    └── ...
环境 B:项目的 venv 虚拟环境
/Users/huapingyu/python-engineering/.venv/
└── lib/python3.12/site-packages/
    ├── httpx
    ├── anyio
    └── ...
两个环境中恰好都安装了 httpx 0.28.1。
但它们是两份独立安装的依赖。
二、为什么退出虚拟环境后还能找到 httpx?
当你执行:
deactivate
python -m pip show httpx
deactivate 会恢复之前的 Shell 环境,使 python 不再默认指向 .venv/bin/python。
此时,你使用的是 pyenv 管理的 Python。
而这个 Python 本来就安装了 httpx,所以当然能够找到。
这就像你的 Mac 上安装了两个独立的应用,它们都包含同名的文件,并不意味着两个应用的数据目录没有隔离。
三、什么情况才值得怀疑隔离失败?
假设:
-
环境 A 没有安装
httpx。 -
你只在环境 B 中安装了
httpx。 -
退出环境 B 后,环境 A 居然能够直接导入环境 B 中的
httpx。
这种情况才需要进一步检查是否存在路径污染、启用了系统包访问,或者其他环境配置问题。
注意,两个环境能否导入同一个包,不是判断隔离是否成功的唯一标准;关键是它们实际从哪里加载这个包。
你可以通过以下命令检查:
python -c "import httpx; print(httpx.__file__)".venv/bin/python -c "import httpx; print(httpx.__file__)"它们应该输出两个不同的安装路径。
7. pyproject.toml:Python 项目的依赖声明
1. 为什么需要 pyproject.toml
你在自己的 Mac 上开发了一个 AI 应用,安装了:
python -m pip install fastapi
python -m pip install httpx
python -m pip install pydantic
项目在你的电脑上运行正常。
但当你把项目代码发给别人时,对方并不知道需要安装哪些依赖。
难道要让对方一个一个猜?
显然不合理。
因此,Python 项目需要一个文件来声明项目依赖。
这就是 pyproject.toml 的重要用途之一。
2. 认识 pyproject.toml
如果有 Java Maven 基础,可以这样建立联系:
| Java / Maven | Python |
|---|---|
pom.xml |
pyproject.toml |
| 声明 dependencies | 声明 dependencies |
| 项目名称、版本 | 项目名称、版本 |
| Maven 插件配置 | Python 构建工具配置 |
不过两者并不完全相同。
pyproject.toml 是 Python 项目配置的标准化入口,本身不负责安装依赖。
实际安装和解析依赖仍然需要 pip、uv 等工具。
一个简单的文件长这样:
[project]
name = "python-engineering"
version = "0.1.0"
requires-python = ">=3.12"

dependencies = [
    "httpx>=0.28.1",
]
我们逐项理解:
| 配置 | 含义 |
|---|---|
name |
项目名称 |
version |
项目版本 |
requires-python |
项目支持的 Python 版本范围 |
dependencies |
项目运行所需的直接依赖 |
这里有个非常重要的区别:
声明依赖 ≠ 安装依赖。
你在文件中写下:
dependencies = [
    "httpx>=0.28.1",
]
只是告诉依赖管理工具:这个项目需要 httpx,版本至少为 0.28.1。
它不会因为你保存了文件,就自动出现在虚拟环境里。
另外,>=0.28.1 是一个版本范围,并不意味着一定安装 0.28.1。
3. 练习
继续使用之前的 python-engineering 项目。
第一步:创建 pyproject.toml
在项目根目录执行:
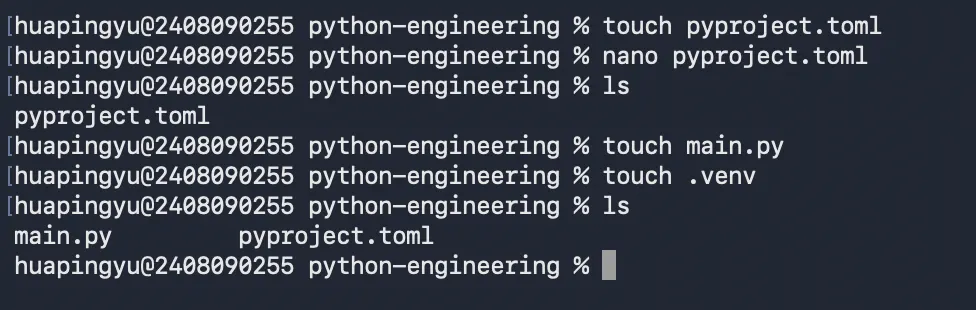
touch pyproject.toml使用 VS Code 或其他编辑器打开它,填入:
[project]
name = "python-engineering"
version = "0.1.0"
requires-python = ">=3.12"

dependencies = [
    "httpx>=0.28.1",
]
保存文件。
第二步:观察项目目录
现在你的项目大致应该是:
python-engineering/
├── .venv/
├── main.py
└── pyproject.toml
如果你之前没有创建 main.py,也没关系,这一关暂时用不到它。
第三步:做一个工程判断
现在请你思考:
假设你把这个项目的代码和 pyproject.toml 发给另一位开发者,但没有把 .venv 文件夹发给他。
他能否根据 pyproject.toml 知道项目需要安装什么依赖?
| 文件 | 作用 |
|---|---|
pyproject.toml |
声明项目需要什么依赖,以及允许的版本范围 |
uv.lock |
记录解析后的具体依赖版本和相关锁定信息 |
.venv/ |
实际安装依赖的环境 |
8. uv:现代 Python 项目管理工具
1. uv 到底解决什么问题?
之前我们需要分别使用不同命令:
python3 -m venv .venv
python -m pip install httpx
python main.py
而 uv 可以统一管理这些工作。
例如:
| 需求 | uv 命令 |
|---|---|
| 初始化项目 | uv init |
| 添加依赖 | uv add httpx |
| 删除依赖 | uv remove httpx |
| 同步依赖环境 | uv sync |
| 运行 Python 程序 | uv run python main.py |
特别注意:uv add 不只是安装依赖,它还会更新项目的依赖声明和锁定信息。
2. 检查是否已经安装 uv
在终端执行:
uv --version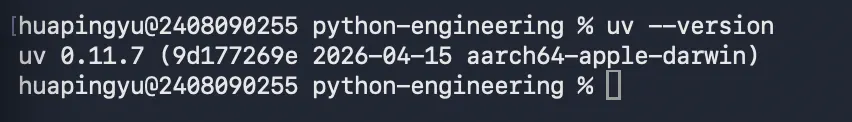
3. uv sync
我们已经手动创建了 pyproject.toml,所以不需要再执行 uv init。
现在直接执行:
uv sync这条命令会根据项目配置解析依赖、生成或更新 uv.lock,并同步项目虚拟环境。
由于你已经有 .venv,uv 通常会复用兼容的环境。
执行完成后,再运行:
ls -a观察是否出现:
uv.lock接着执行:
uv run python -c "import httpx; print(httpx.__version__)"如果正常,应该输出一个满足项目依赖要求的 httpx 版本。
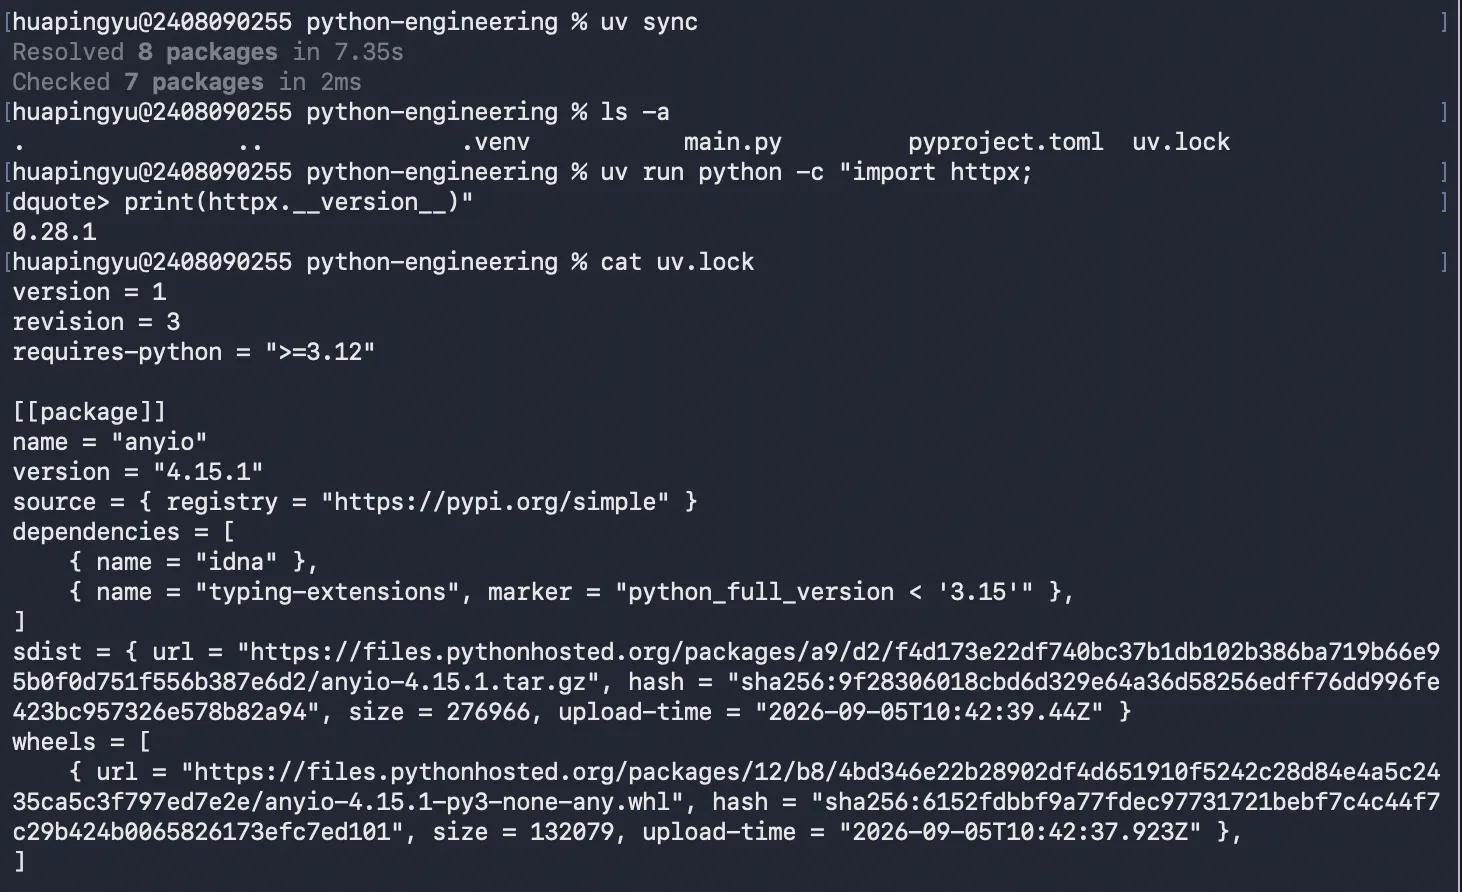
4. uv.lock
你刚才输出了整个 uv.lock,但实际上,我们只需要关注几个字段。
以 httpx 为例:
[[package]]
name = "httpx"
version = "0.28.1"
source = { registry = "https://pypi.org/simple" }

dependencies = [
    { name = "anyio" },
    { name = "certifi" },
    { name = "httpcore" },
    { name = "idna" },
]
这里记录了:
-
name:包名称。
-
version:解析后锁定的具体版本。
-
source:依赖来源。
-
dependencies:这个包依赖哪些其他包。
5. uv add
假设 AI Gateway 项目准备使用 FastAPI 提供 HTTP 服务。
你不需要再手动编辑 pyproject.toml,直接执行:
uv add fastapi这条命令通常会自动完成三件事:
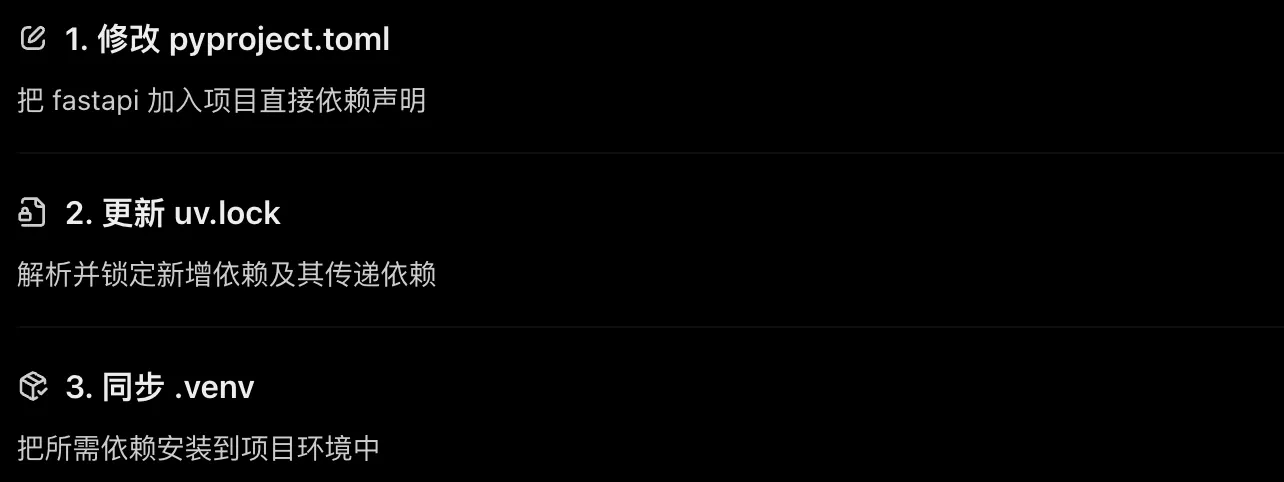
在 python-engineering 目录执行:
uv add fastapi然后执行:
cat pyproject.toml最后验证:
uv run python -c "import fastapi; print(fastapi.__version__)"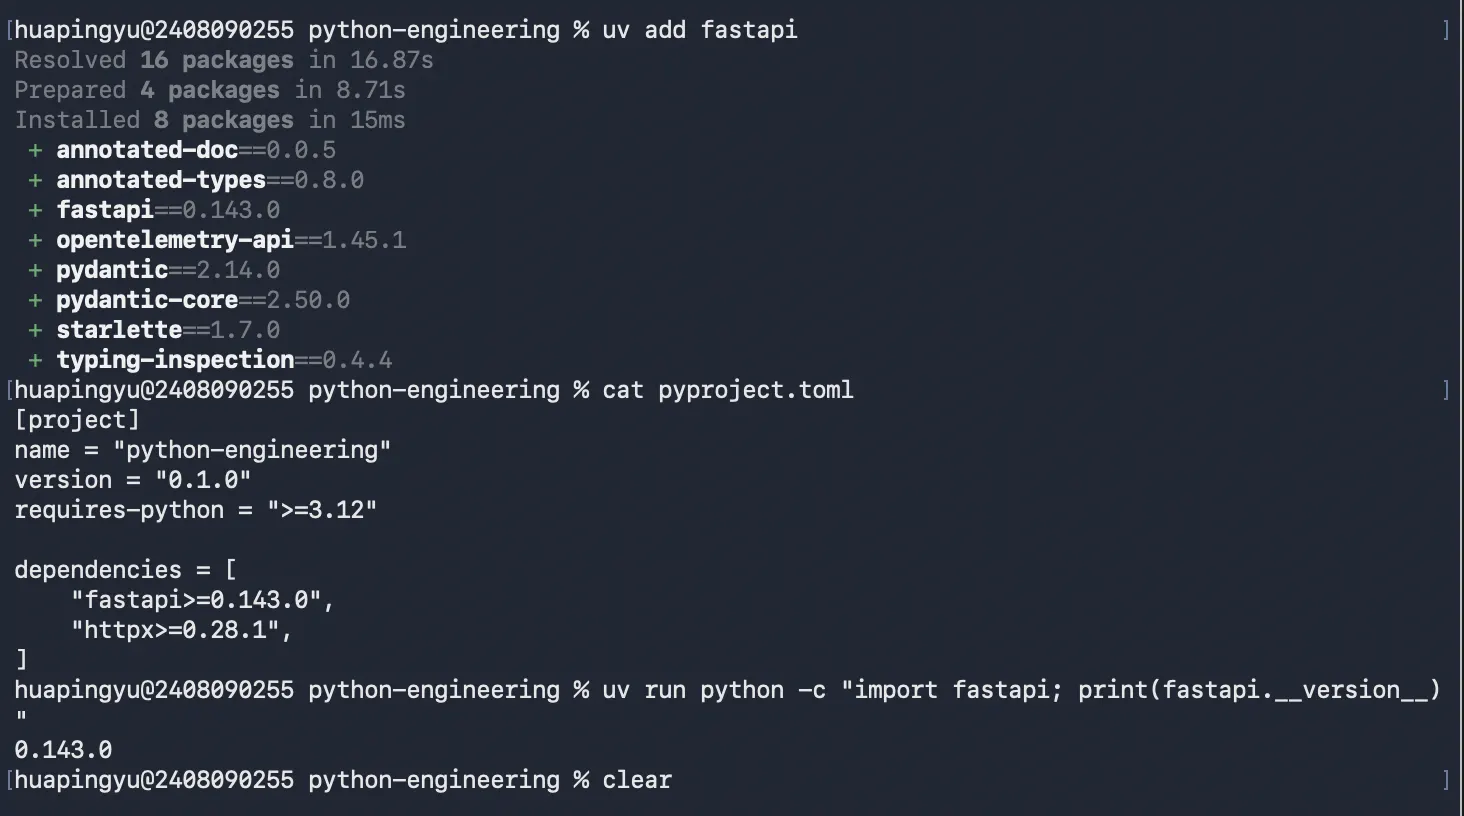
为什么我们只执行了一条 uv add fastapi,却不需要再分别执行 pip install 和 uv sync?
因为 uv add 不只是安装依赖,而是一个完整的项目依赖管理操作。
执行:
uv add fastapi默认会依次完成:
-
更新
pyproject.toml中的依赖声明。 -
解析依赖关系,更新
uv.lock。 -
将解析后的依赖同步到
.venv。
因此不需要再单独执行 pip install 和 uv sync。
6. 区分三个核心命令
| 命令 | 主要用途 |
|---|---|
uv add fastapi |
给项目新增依赖,并更新锁定文件和环境 |
uv sync |
根据项目声明和锁定文件同步环境 |
uv run python main.py |
在项目环境中运行程序,必要时先同步环境 |
这里有一个工程细节:uv sync 默认会移除不属于当前项目依赖集合的多余包,因此不要把 .venv 当作永久存放手动安装软件的地方。
2. Python 项目结构 & 配置管理
1. 为什么需要「模块与包」
假设你正在开发一个 AI Agent 后端。
最初,你可能把所有代码写在一个 main.py 文件中:
# main.py

def call_llm():
    print("调用大模型 API")

def save_message():
    print("保存消息")

def handle_chat():
    call_llm()
    save_message()

handle_chat()
代码只有十几行时,这样写没有问题。
但当项目逐渐增加 API 路由、模型调用、数据处理等功能,所有代码堆在一个文件中,就会变得难以维护。
这时我们需要通过**模块(Module)和包(Package)**组织代码。
2. 模块与包的区别
-
模块: 通常是一个
.py文件。 -
包: 用于组织多个模块的结构,通常表现为一个目录。现代 Python 也支持不包含
__init__.py的命名空间包。
例如:
python-engineering/
├── main.py
├── services/
│   ├── __init__.py
│   └── llm.py
├── pyproject.toml
└── uv.lock
这里:
-
llm.py是模块。 -
services是包。 -
__init__.py让services成为常规 Python 包。
3. 练习
继续使用现有的 python-engineering 项目。
创建目录和文件:
mkdir -p services
touch services/__init__.py
touch services/llm.py
在 services/llm.py 中编写:
def call_llm():
    return "来自大模型的响应"
然后在 main.py 中编写:
from services.llm import call_llm

result = call_llm()
print(result)
运行:
uv run python main.py预期输出:
来自大模型的响应-
ModuleNotFoundError:通常表示模块没有被找到。 -
ImportError: cannot import name:模块可能已经找到,但无法导入指定名称。
4. import 的基本原理
Python 到底是如何找到要导入的模块的?
当 Python 执行:
from services.llm import call_llm它需要完成两件事:
-
找到
services.llm模块。 -
从模块中获取
call_llm这个名称。
1. 那么 Python 去哪里寻找模块呢?
其中一个关键因素就是 sys.path。
它是 Python 的模块搜索路径列表。
例如:
sys.path
├── 当前程序所在目录(取决于启动方式)
├── PYTHONPATH 指定的目录(如果有)
├── Python 标准库目录
└── site-packages 等目录
Python 导入模块时,会使用这些搜索路径,并结合其他导入机制寻找模块。
这也解释了为什么有些 Python 项目会出现:
明明文件存在,但运行时却提示
ModuleNotFoundError。
因为文件存在,不代表它所在的目录一定处于模块搜索范围内。
2. 动手观察 sys.path
继续使用之前的项目:
python-engineering/
├── main.py
└── services/
    ├── __init__.py
    └── llm.py
先执行:
.venv/bin/python -c "import sys; print(*sys.path, sep='\n')"你会看到若干路径。
接着执行:
.venv/bin/python -c "import services.llm; print(services.llm.__file__)"预期输出:
/Users/huapingyu/python-engineering/services/llm.py这说明 Python 找到了对应的模块文件。
3. 再做一个对比实验
现在切换到项目的 services 目录:
cd services然后执行:
../.venv/bin/python -c "import llm; print(llm.__file__)"这次我们不再写 services.llm,而是直接导入 llm。
观察输出。
注意: 我们没有修改任何 Python 代码,只是改变了执行命令时所在的目录和导入方式。
4. PATH & sys.path
| 你的理解 | 判断 |
|---|---|
PATH 服务于 Shell 查找可执行程序 |
正确 |
sys.path 服务于 Python 导入模块和包 |
正确 |
| 两者都涉及根据搜索路径查找目标 | 正确 |
sys.path 通常记录搜索起点,而非模块完整路径 |
正确 |
sys.path 受到 Python 启动方式和工作目录影响 |
正确,但需要补充条件 |
第一个细节:PATH 和 sys.path 不是同一个东西
你说「变化的是 path」,这里可以表达得更准确一些。
实际上是两套不同的搜索机制:
Shell 执行命令
    ↓
读取 PATH 环境变量
    ↓
在指定目录中寻找可执行程序
    ↓
执行程序
Python 执行 import
↓
使用 Python 的导入机制
↓
根据 sys.path 等信息寻找模块或包
↓
加载模块注意,sys.path 只是 Python 导入机制的一部分,并不是所有模块都必须通过它查找。例如内置模块就不需要依赖普通文件路径搜索。
另外,Shell 的 PATH 是环境变量,而 Python 的 sys.path 是一个列表对象。
第二个细节:工作目录不是始终决定 sys.path
这是我们之前容易混淆的地方。
对于:
python -c "import llm"Python 通常会把当前工作目录作为模块搜索位置之一。
但对于:
python services/llm.pyPython 通常会优先把脚本所在目录放入 sys.path。
所以不能简单认为「终端在哪里,Python 就一定从哪里开始搜索」。
5. 项目目录设计
1. 项目目录设计
你之前使用过 Spring Boot,应该比较熟悉这种结构:
src/main/java/com/example/
├── controller/
├── service/
├── repository/
└── config/
这些目录的核心目的,是把不同职责的代码分开。
Python 后端也是类似的思路。
假设我们开发一个 AI 聊天 API,可以采用下面这种结构:
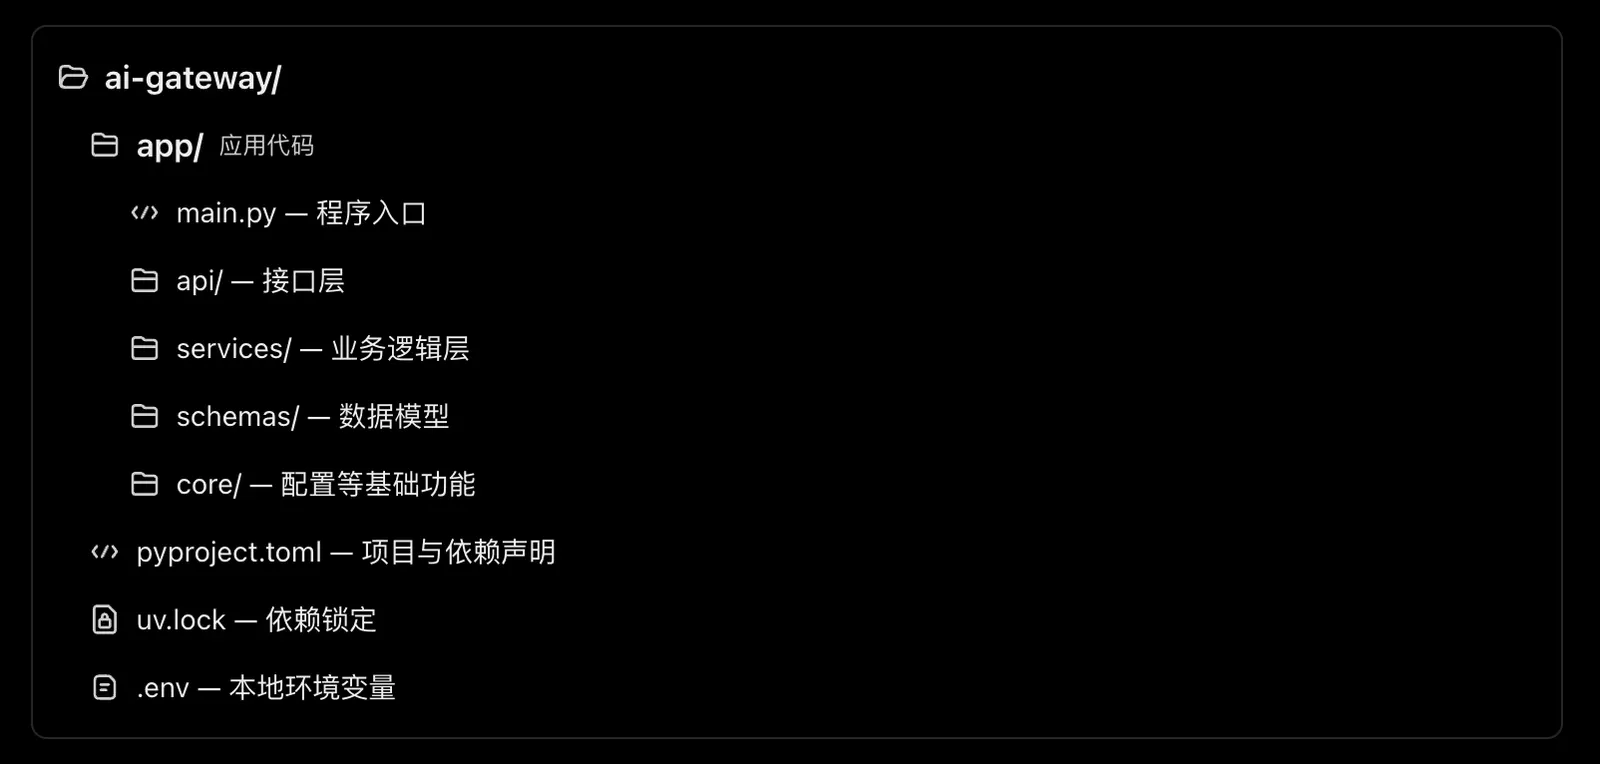
这些目录分别承担什么职责?
| 目录 | 作用 | Spring Boot 类比 |
|---|---|---|
api/ |
接收 HTTP 请求、返回响应 | Controller |
services/ |
处理业务逻辑、调用大模型 | Service |
schemas/ |
定义请求、响应的数据结构 | DTO |
core/ |
配置、日志等基础功能 | Config |
main.py |
创建并启动应用的入口 | Application |
注意:这是一种常见组织方式,不是 Python 强制规定的标准。
项目结构应该随着复杂度增长,而不是一开始就把所有目录建齐。
2. 动手:把现有项目整理成分层结构
这次我们只拆分两个职责:
-
main.py:负责调用业务功能。 -
services/llm.py:负责模拟大模型响应。
你之前已经写过这些代码,所以不用重新创建项目。
当前结构:
python-engineering/
├── main.py
└── services/
    ├── __init__.py
    └── llm.py
我们先保留这个结构,不急着引入 api/、schemas/ 等目录。
第一步:修改业务层
打开:
nano services/llm.py改成:
def generate_response(message: str) -> str:
    return f"AI 收到了你的消息:{message}"
第二步:修改程序入口
打开:
nano main.py改成:
from services.llm import generate_response

message = "你好,请介绍一下自己"

response = generate_response(message)

print(response)
第三步:运行
考虑到之前 uv 的网络超时问题,这次直接使用虚拟环境:
cd ~/python-engineering
.venv/bin/python main.py
预期输出:
AI 收到了你的消息:你好,请介绍一下自己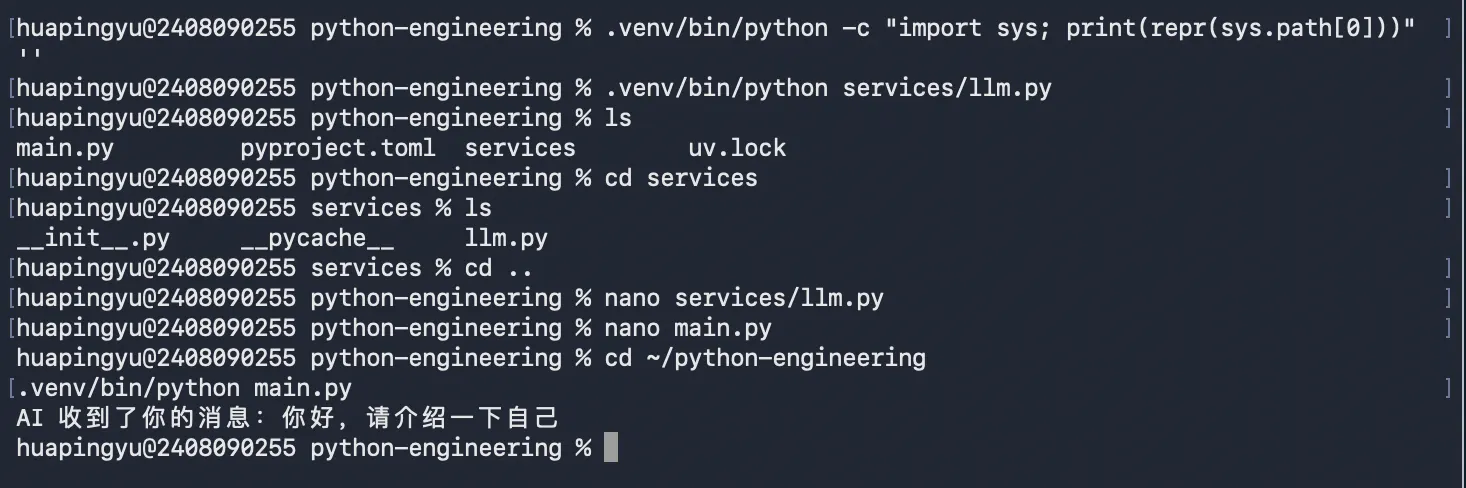
3. 这次需要掌握的工程原则
让代码按照职责组织,而不是按照代码量随意拆分。
例如,未来真正接入 FastAPI 后:
-
API 层负责接收用户消息。
-
Service 层负责调用大模型。
-
Schema 层负责验证消息格式。
API 层不应该承担全部的大模型调用、数据处理和异常处理逻辑。
6. Python 项目配置管理
1. 为什么需要配置管理?
假设你正在开发一个调用大模型的 Python 项目。
最直接的写法是:
API_KEY = "sk-xxxxxxxx"
MODEL = "gpt-4.1"
BASE_URL = "https://api.example.com/v1"
代码可以运行,但存在几个问题:
-
API Key 写死在代码里,容易意外提交到 GitHub。
-
切换模型需要修改代码。
-
本地和服务器使用不同配置时,不方便管理。
因此,我们希望把配置与业务代码分离。
这和之前学习 Spring Boot 时使用的 application.yml 有些类似。
2. 练习
1. 第一步:先使用环境变量
在 Linux 学习阶段已经接触过:
export AGENT_NAME=FridayPython 可以通过标准库 os 读取环境变量。
先进入项目目录:
cd ~/python-engineering创建一个 config_demo.py:
import os

agent_name = os.getenv("AGENT_NAME")

print(f"Agent 名称:{agent_name}")
然后执行:
export AGENT_NAME=Friday
.venv/bin/python config_demo.py
预期输出:
Agent 名称:Friday执行:
unset AGENT_NAME
.venv/bin/python config_demo.py
预期输出:
Agent 名称:None这里有一个你需要掌握的方法:
os.getenv("AGENT_NAME")它的作用是读取名为 AGENT_NAME 的环境变量。
如果不存在,默认返回 None。
也可以指定默认值:
os.getenv("AGENT_NAME", "DefaultAgent")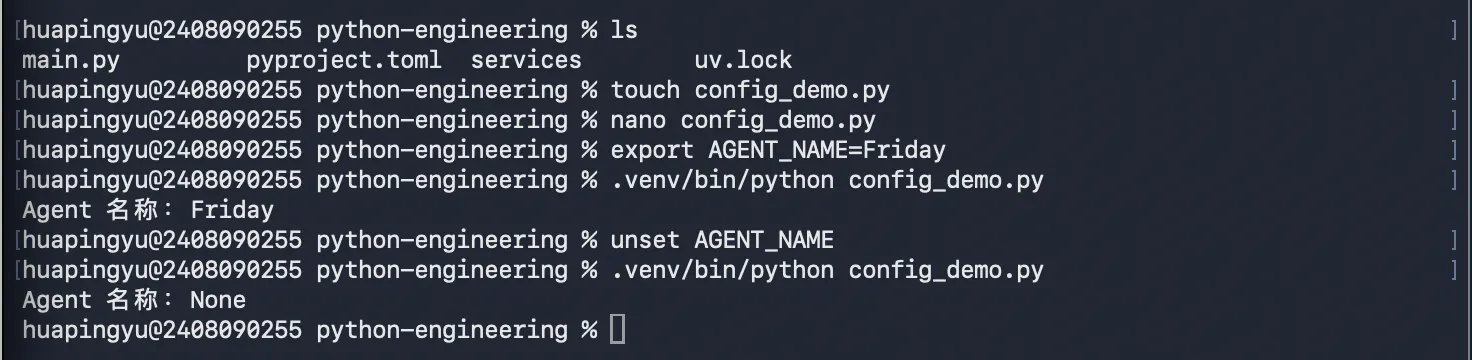
2. 第二步:为什么还需要 .env?
如果项目有十几个配置,每次打开终端都要执行:
export AGENT_NAME=Friday
export MODEL_NAME=gpt-4.1
export API_KEY=xxx
就比较麻烦了。
我们可以创建一个 .env 文件:
AGENT_NAME=Friday
MODEL_NAME=gpt-4.1
API_KEY=your-test-key
但有一个非常重要的区别:
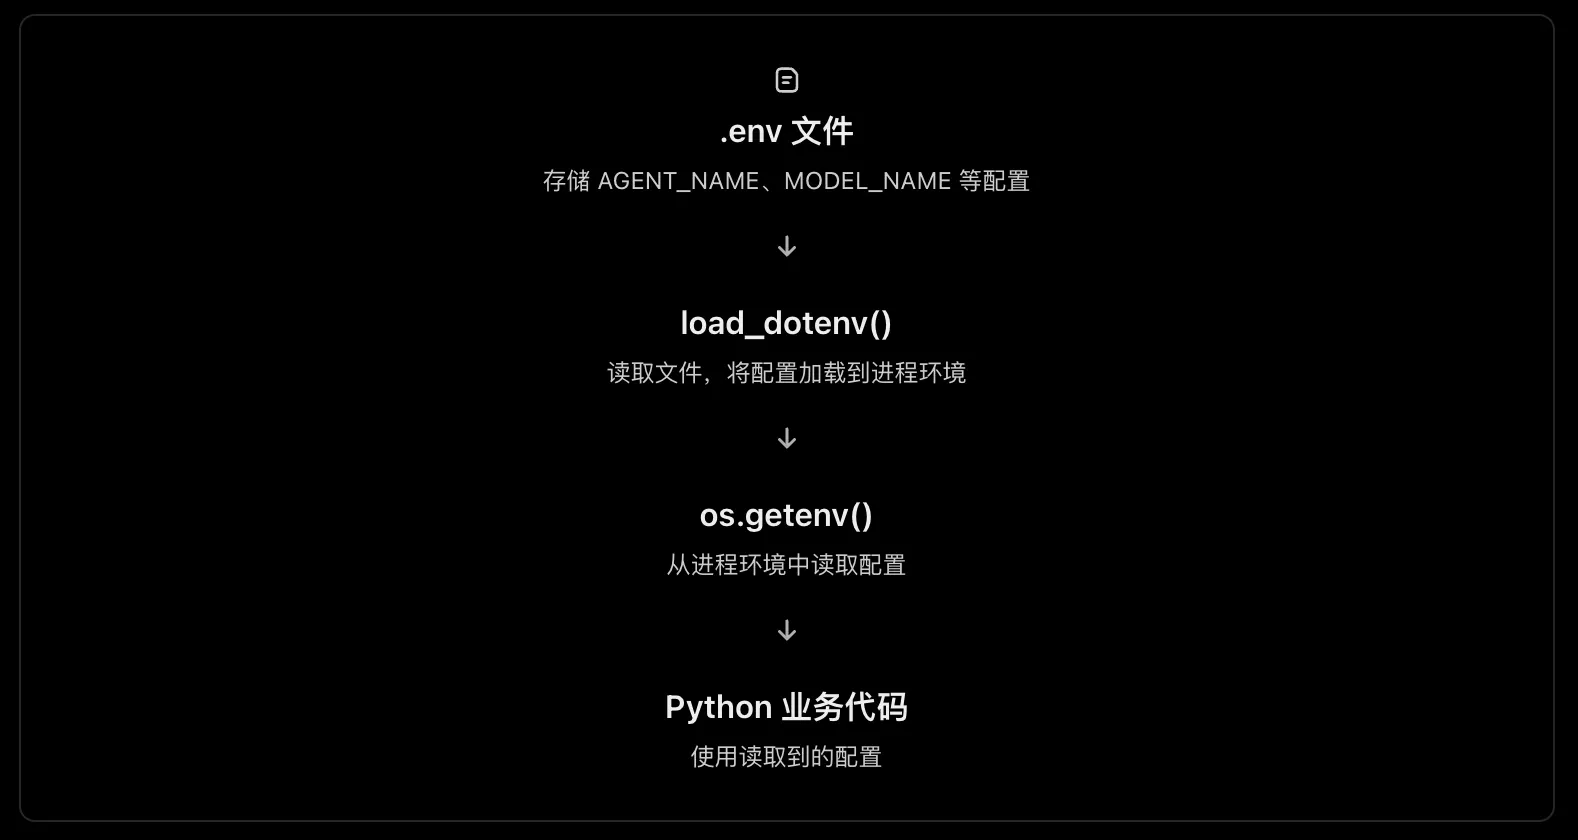
Python 不会自动读取 .env 文件。
os.getenv() 读取的是进程环境变量,而 .env 只是一个普通文本文件。
所以我们需要一个工具,把 .env 中的配置加载进来。
Python 常见的选择是 python-dotenv,后面学习 Pydantic 时,我们还会接触更适合工程项目的配置管理方式。
3. .env 文件管理配置
1. 为什么需要 .env
刚才使用的是:
export AGENT_NAME=Friday这种方式会把变量设置到当前 Shell 环境中,随后启动的 Python 进程可以读取它。
但如果我们有十几个配置,每次都要 export,就比较麻烦。
因此可以把配置集中写进 .env 文件:
AGENT_NAME=Friday
MODEL_NAME=gpt-4.1
API_KEY=your-test-key
然后让 Python 程序读取它们。
这里要记住一个区别:
-
.env:存储配置的文本文件。 -
os.getenv():读取进程环境变量。 -
python-dotenv:帮助 Python 从.env文件加载配置。
.env 文件本身不会自动变成环境变量。
2. 练习:创建 .env 文件
进入项目目录:
cd ~/python-engineering创建文件:
nano .env写入:
AGENT_NAME=Friday
MODEL_NAME=gpt-4.1
API_KEY=your-test-key
这里的 API Key 只是测试字符串,不需要填写真实密钥。
3. 安装 python-dotenv
你之前已经学习过 uv add,直接使用:
uv add python-dotenv安装成功后,修改 config_demo.py:
import os
from dotenv import load_dotenv

load_dotenv()

agent_name = os.getenv("AGENT_NAME")
model_name = os.getenv("MODEL_NAME")
api_key = os.getenv("API_KEY")

print(f"Agent 名称:{agent_name}")
print(f"模型名称:{model_name}")
print(f"API Key:{api_key}")
这里新增的核心代码只有两行:
from dotenv import load_dotenv

load_dotenv()
load_dotenv() 会查找并读取 .env 文件,将其中的配置加载到进程环境中。默认情况下,它不会覆盖已经存在的环境变量。
4. 运行验证
执行:
.venv/bin/python config_demo.py预期输出:
Agent 名称:Friday
模型名称:gpt-4.1
API Key:your-test-key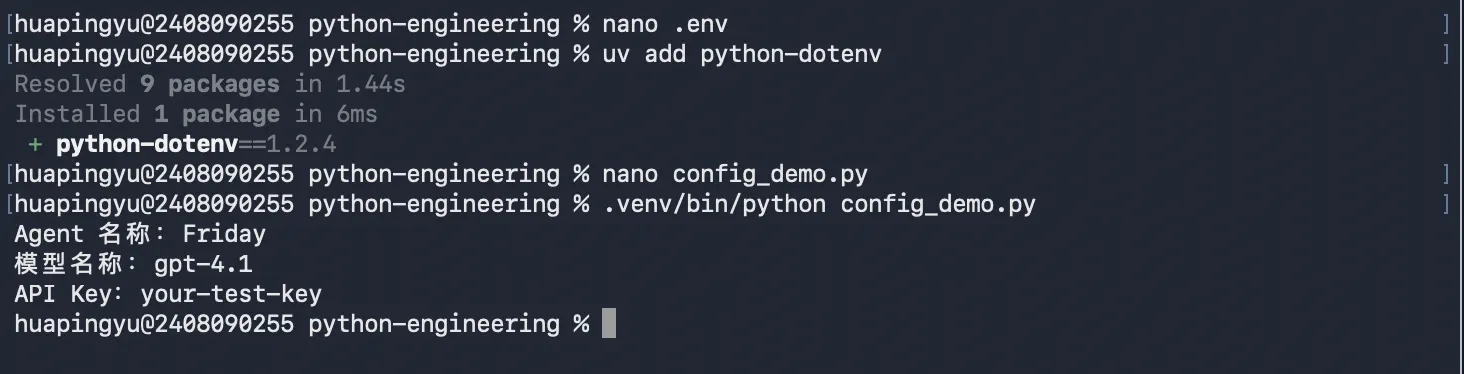
理解整个过程
4. .gitignore 与配置安全
1. 为什么需要 .gitignore?
现在的项目大致是:
python-engineering/
├── .env
├── .venv/
├── main.py
├── config_demo.py
├── services/
├── pyproject.toml
└── uv.lock
其中有些文件适合提交到 GitHub,有些不适合。
| 文件 | 是否提交 Git | 原因 |
|---|---|---|
main.py、services/ |
是 | 项目源代码 |
pyproject.toml |
是 | 声明项目依赖 |
uv.lock |
是 | 锁定依赖版本 |
.env |
否 | 可能包含 API Key 等敏感信息 |
.venv/ |
否 | 本地虚拟环境,可以重新创建 |
.gitignore 的作用就是告诉 Git:哪些尚未被跟踪的文件不需要纳入版本控制。
二、动手创建 .gitignore
确保当前在项目根目录:
cd ~/python-engineering创建并编辑:
nano .gitignore写入以下内容:
# 环境变量与密钥
.env
.env.*

# Python 虚拟环境
.venv/

# Python 缓存
__pycache__/
*.pyc

# macOS
.DS_Store
这里的 .env.* 也会匹配 .env.example。但 .env.example 通常是可以提交的配置模板,所以再加上一行例外:
!.env.example最终保存即可。
3. 验证规则是否生效
这次不需要创建 Git 仓库,也不需要提交代码。
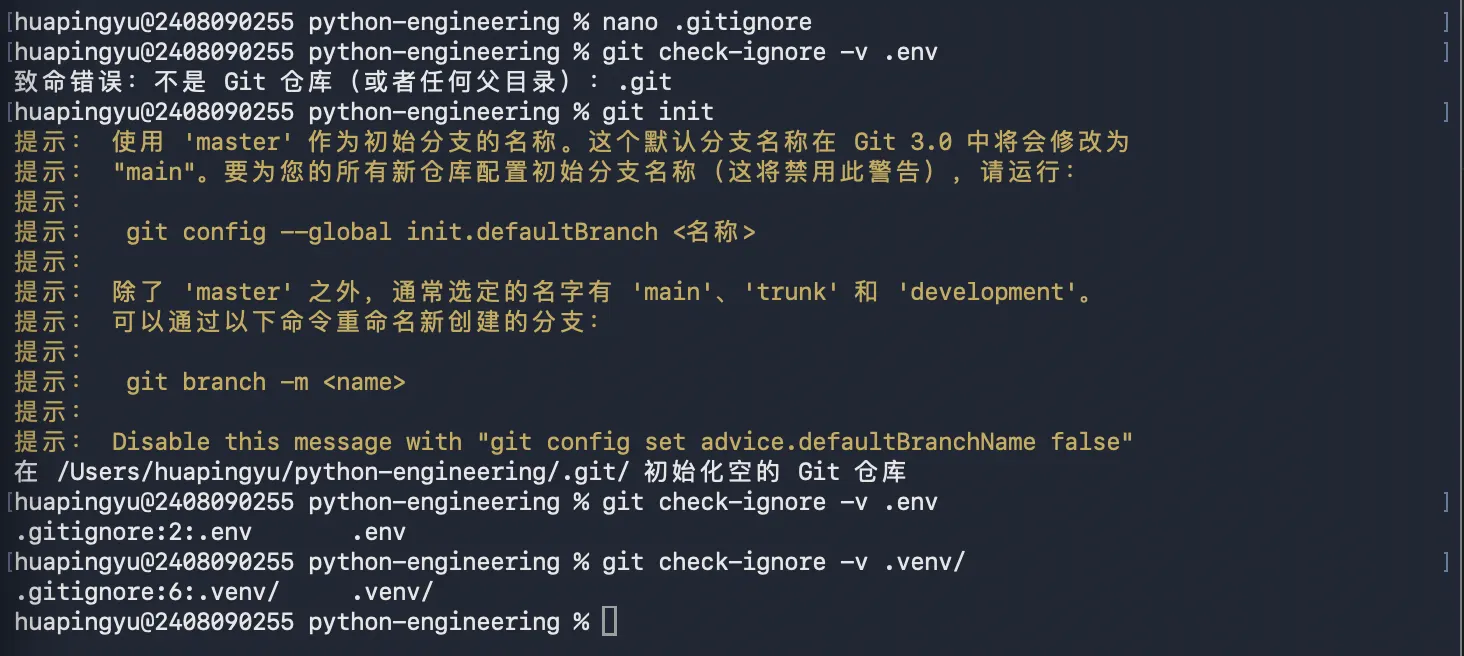
如果项目已经初始化过 Git,可以执行:
git check-ignore -v .env
git check-ignore -v .venv/
预期会显示对应的 .gitignore 规则。
如果出现:
fatal: not a git repository也没关系,说明当前项目还不是 Git 仓库。
你可以先执行:
git init然后重新运行上面两条检查命令。
注意:如果敏感文件之前已经被 Git 跟踪,后来才加入 .gitignore,它不会自动停止跟踪,更不会清除历史提交中的密钥。
4. 再补充一个实际项目中的习惯
真实项目一般还会创建一个 .env.example:
AGENT_NAME=Friday
MODEL_NAME=gpt-4.1
API_KEY=
这个文件可以提交到 GitHub,让其他开发者知道项目需要哪些配置,但不包含真实密钥。
这样就形成了:
-
.env:本地真实配置,不提交。 -
.env.example:配置模板,可以提交。 -
.gitignore:保护不应提交的文件。
3. HTTP 请求与 requests / httpx
1. 什么是同步请求?
假设你的 AI Agent 需要分别调用三个服务:
-
服务 A:查询天气,需要 2 秒。
-
服务 B:查询新闻,需要 3 秒。
-
服务 C:查询股票,需要 2 秒。
如果采用同步请求,执行过程大致是:
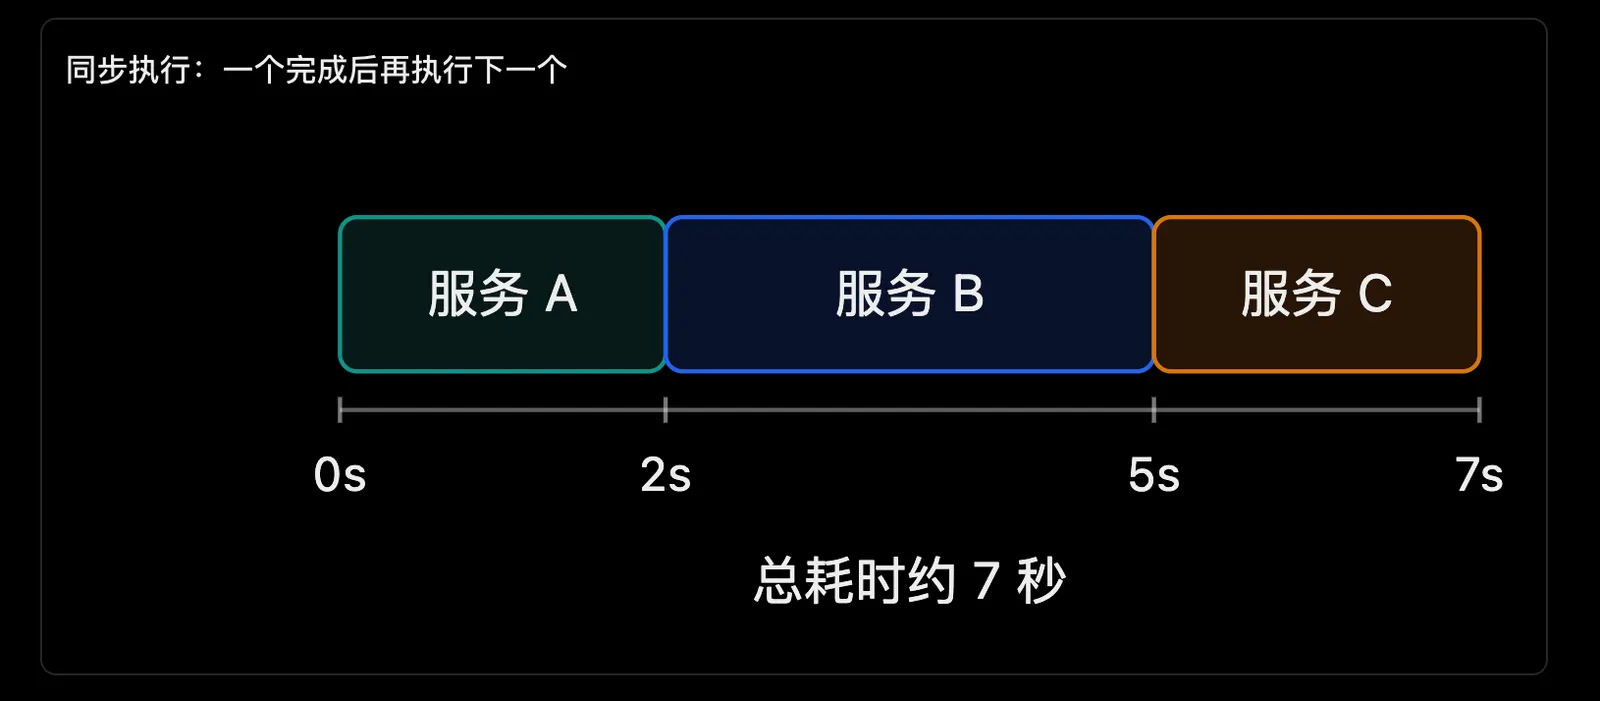
代码类似:
result_a = call_service_a()  # 等待 2 秒
result_b = call_service_b()  # 等待 3 秒
result_c = call_service_c()  # 等待 2 秒
每次调用都需要等待前一次完成。
2. 什么是异步请求?
如果这三个请求相互独立,就可以让它们并发执行。
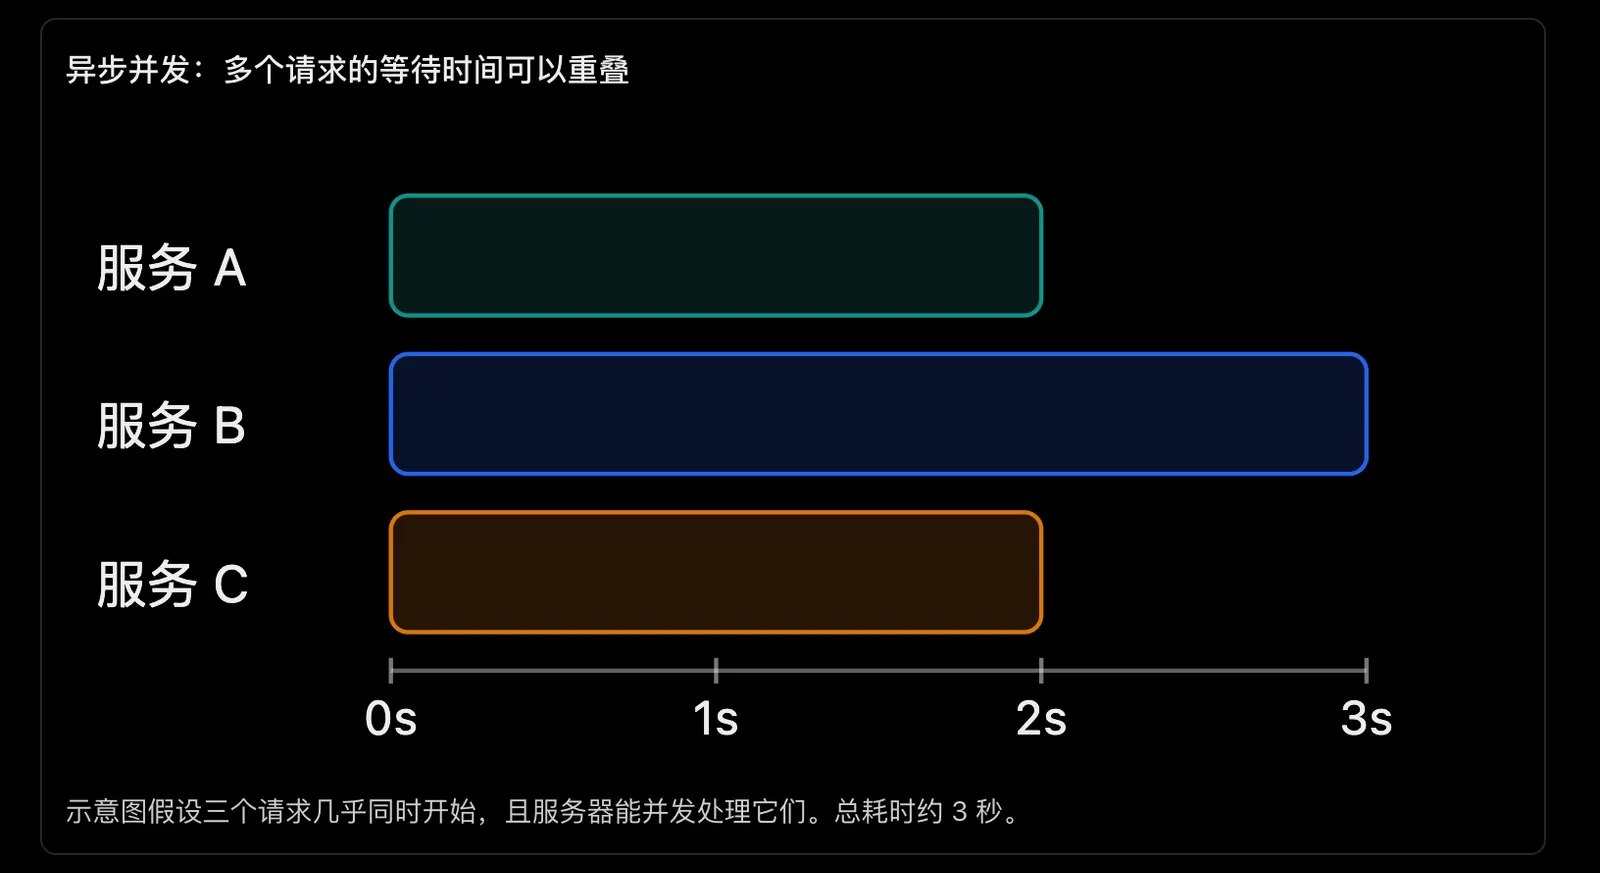
这里要特别注意:
异步不等于三个 Python 函数同时在三个 CPU 核心上执行。
在我们这个场景中,异步的主要价值是:当某个请求正在等待网络响应时,程序可以切换去处理其他请求。
这对于需要同时调用多个外部工具的 AI Agent 很有用。
3. 认识 async 和 await
Python 中的异步函数通常这样定义:
async def fetch_data():
    ...
调用异步操作时,可以使用:
await some_async_operation()先记住:
-
async def:定义异步函数。 -
await:等待异步操作完成,并允许事件循环在等待期间调度其他任务。 -
asyncio.run():从普通同步程序入口运行一个异步协程。
但还有一个容易误解的地方:
只使用 async 和 await,并不代表多个请求就会自动并发。
要实现多个请求并发执行,还需要使用 asyncio.gather() 等工具。
4. 练习:第一次使用 AsyncClient
这次我们先只发送一个异步 HTTP 请求,不急着学习并发。
清空并编辑之前的文件:
truncate -s 0 http_demo.py
nano http_demo.py
写入:
import asyncio
import httpx


async def main():
    async with httpx.AsyncClient(
        base_url="https://httpbin.org",
        timeout=10.0
    ) as client:

        response = await client.get("/get")

        response.raise_for_status()

        print("状态码:", response.status_code)
        print("请求 URL:", response.url)


asyncio.run(main())
运行:
.venv/bin/python http_demo.py预期输出:

5. 和上一关的 Client 有什么区别?
| 同步 Client | 异步 AsyncClient |
|---|---|
with httpx.Client() |
async with httpx.AsyncClient() |
client.get() |
await client.get() |
普通 def 函数 |
async def 函数 |
| 顺序阻塞等待 | 支持非阻塞的异步等待 |
注意,AsyncClient 不是一定比 Client 更快。对于单个 HTTP 请求,两者耗时可能差不多。异步的优势主要体现在多个 I/O 操作可以并发等待。
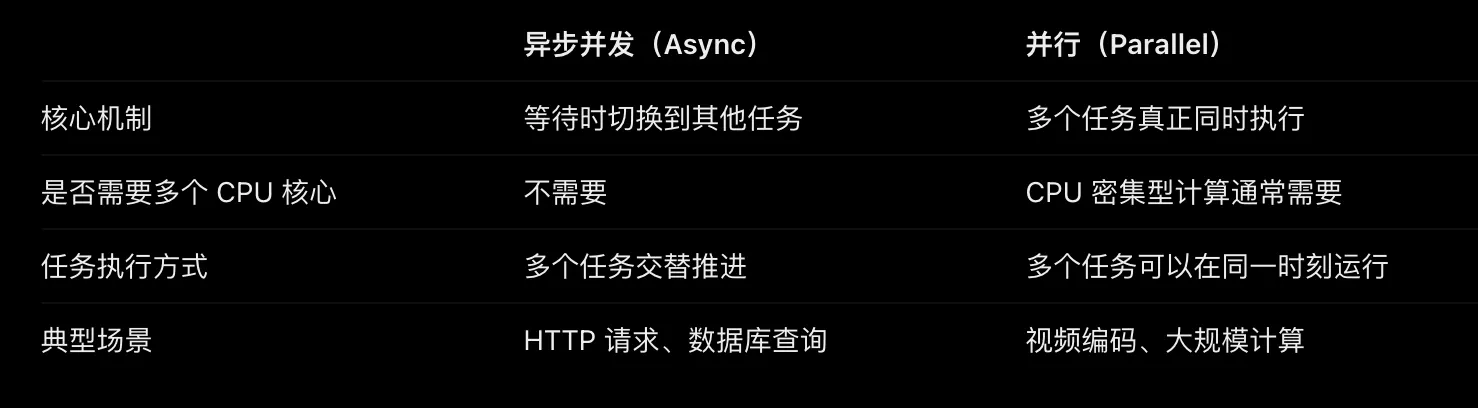
6. 异步的核心到底是什么
对于现在学习的 Python asyncio,异步的核心是:
一个任务遇到需要等待的操作时,可以暂停自己,让其他任务先执行。等等待条件满足后,再恢复执行。
它并不是简单地让多个任务同时在 CPU 上运行。
1. 异步和并行的区别
2. 用你熟悉的 Agent 举例
假设一个 Agent 需要调用两个工具:
-
A:调用大模型 API,等待响应 3 秒。
-
B:查询天气 API,等待响应 2 秒。
在单线程 asyncio 中,如果两个任务被安排为并发执行:
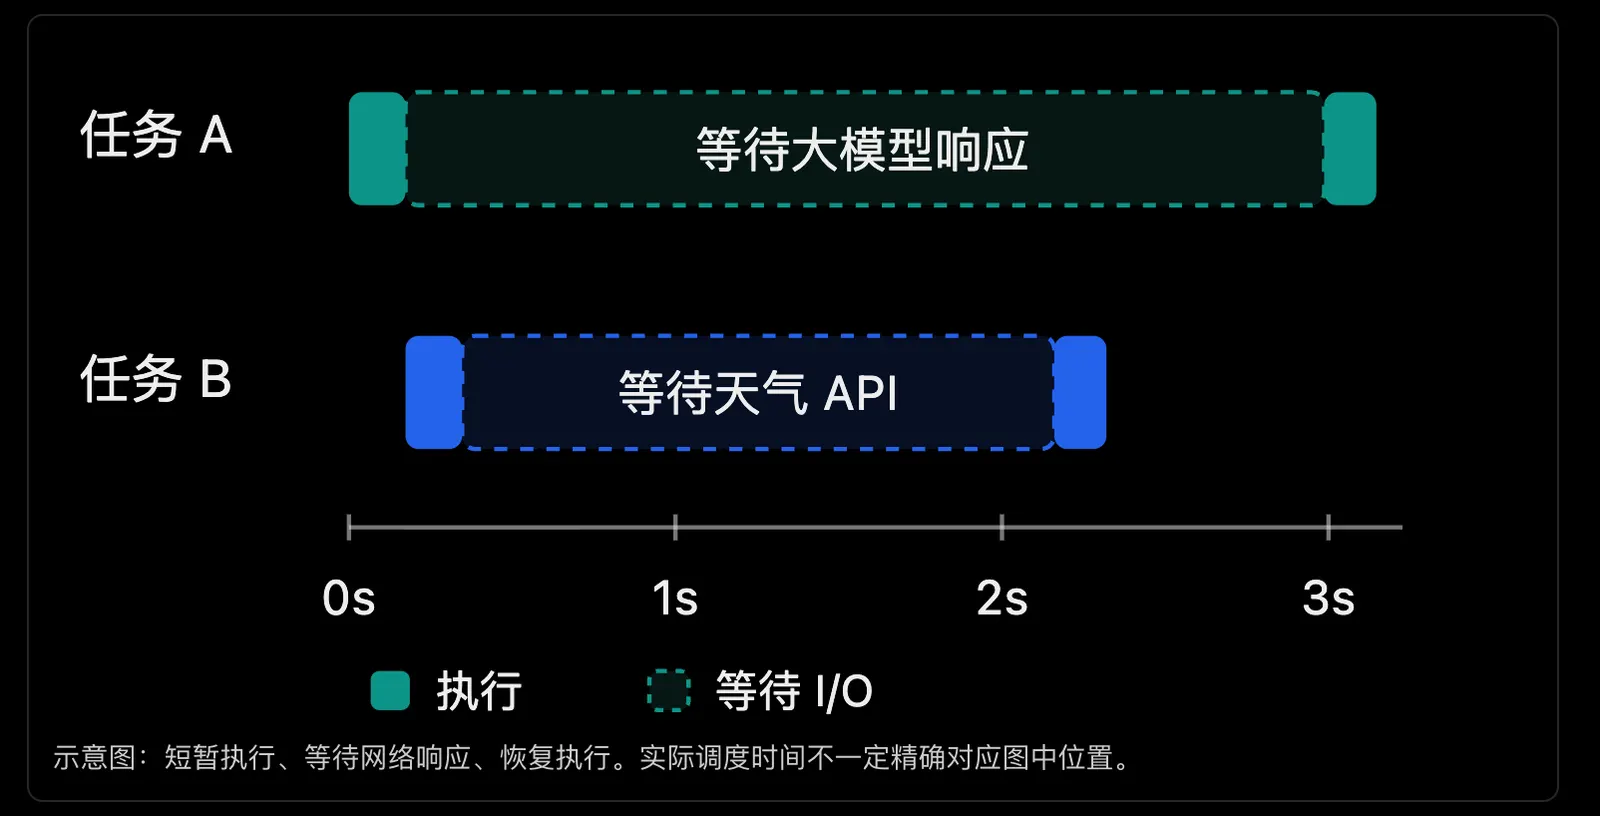
大致执行过程是:
-
任务 A 开始,发送大模型请求。
-
A 遇到
await,需要等待网络响应,于是让出执行机会。 -
事件循环开始执行任务 B,发送天气请求。
-
B 也遇到
await,让出执行机会。 -
天气 API 先返回,B 恢复执行并完成。
-
大模型 API 返回,A 恢复执行并完成。
所以两个任务的等待时间发生了重叠,总耗时大约 3 秒,而不是 5 秒。
3. 那异步是不是跟任务进度有关系?
有关系,但更准确地说,是跟任务能不能主动让出执行机会有关。
Python 的 asyncio 主要采用协作式调度。
例如:
async def task_a():
    await asyncio.sleep(3)
这里任务 A 可以暂停,其他任务就有机会执行。
但如果你写:
async def task_a():
    while True:
        pass
即使加了 async,这个无限循环也没有正常让出执行机会,会一直占用事件循环所在的线程,导致其他协程无法正常推进。
因此:
-
async def不代表自动并发。 -
await是协程可能暂停、让出执行机会的重要位置。 -
asyncio.gather()等机制负责安排多个协程并发执行。 -
事件循环负责在可运行的任务之间进行调度。
一句话总结:异步并发的核心不是多个任务必须同时执行,而是一个任务等待时,其他任务可以继续推进。
7. 练习-对比同步请求和异步并发请求的耗时
1. 练习目标
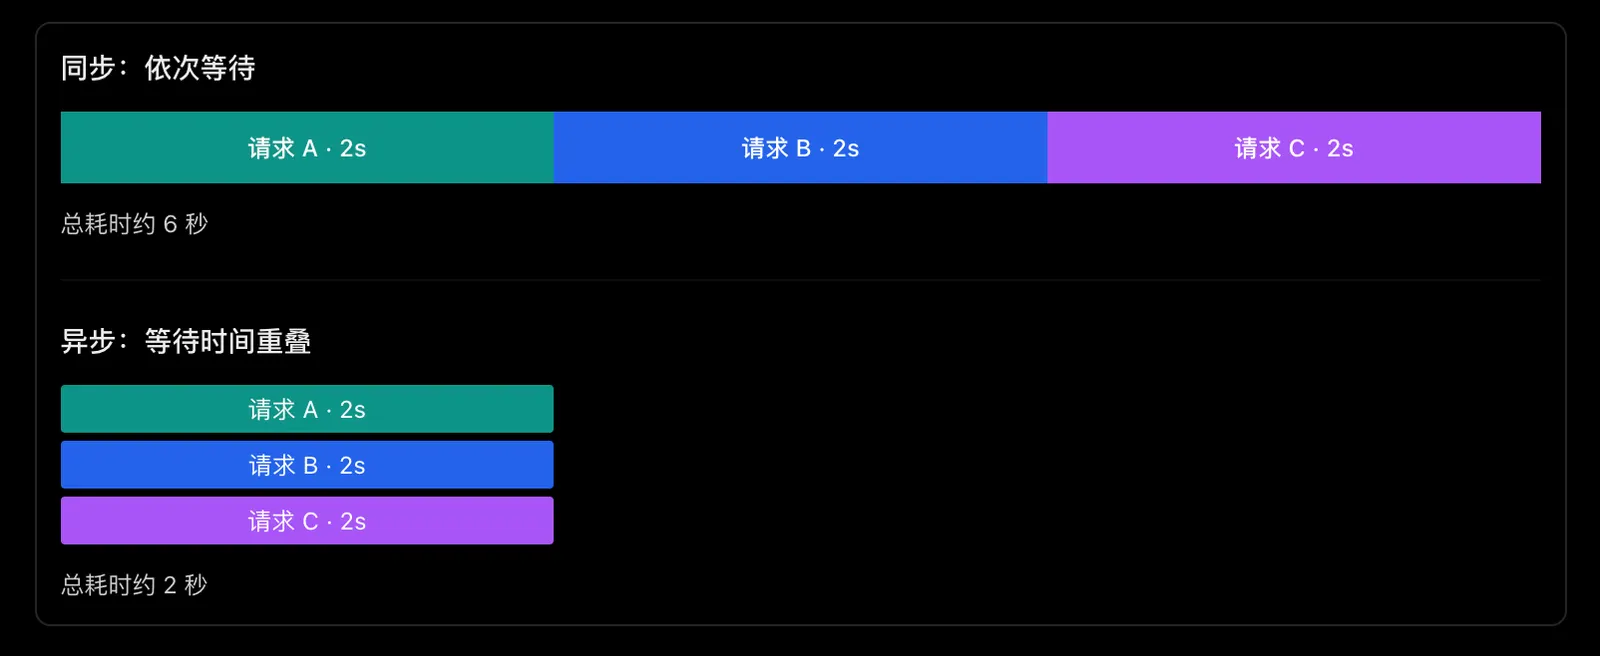
假设你的 Agent 需要同时调用 3 个外部 API,每个 API 都需要等待约 2 秒。
我们分别使用:
-
同步请求:
httpx.Client -
异步并发请求:
httpx.AsyncClient+asyncio.gather()
理论耗时:
2. 创建练习文件
在你的 ~/python-engineering 项目目录中执行:
cd ~/python-engineering
nano async_http_demo.py
将下面的完整代码复制进去:
import asyncio
import time

import httpx

URL = "https://httpbin.org/delay/2"


# 1. 同步请求
def sync_demo():
    print("===== 同步请求 =====")

    start = time.perf_counter()

    with httpx.Client(timeout=15.0) as client:
        for i in range(1, 4):
            response = client.get(URL)
            response.raise_for_status()
            print(f"请求 {i} 完成:{response.status_code}")

    elapsed = time.perf_counter() - start
    print(f"同步总耗时:{elapsed:.2f} 秒")


# 2. 异步请求
async def fetch(client, i):
    response = await client.get(URL)
    response.raise_for_status()

    print(f"请求 {i} 完成:{response.status_code}")


async def async_demo():
    print("\n===== 异步并发请求 =====")

    start = time.perf_counter()

    async with httpx.AsyncClient(timeout=15.0) as client:
        await asyncio.gather(
            fetch(client, 1),
            fetch(client, 2),
            fetch(client, 3)
        )

    elapsed = time.perf_counter() - start
    print(f"异步总耗时:{elapsed:.2f} 秒")


# 3. 程序入口
sync_demo()
asyncio.run(async_demo())
这里用 time.perf_counter() 计算真实耗时。httpbin.org/delay/2 用于模拟需要等待的 HTTP 请求,但公共服务的响应时间可能受到网络、限流或服务器负载影响。
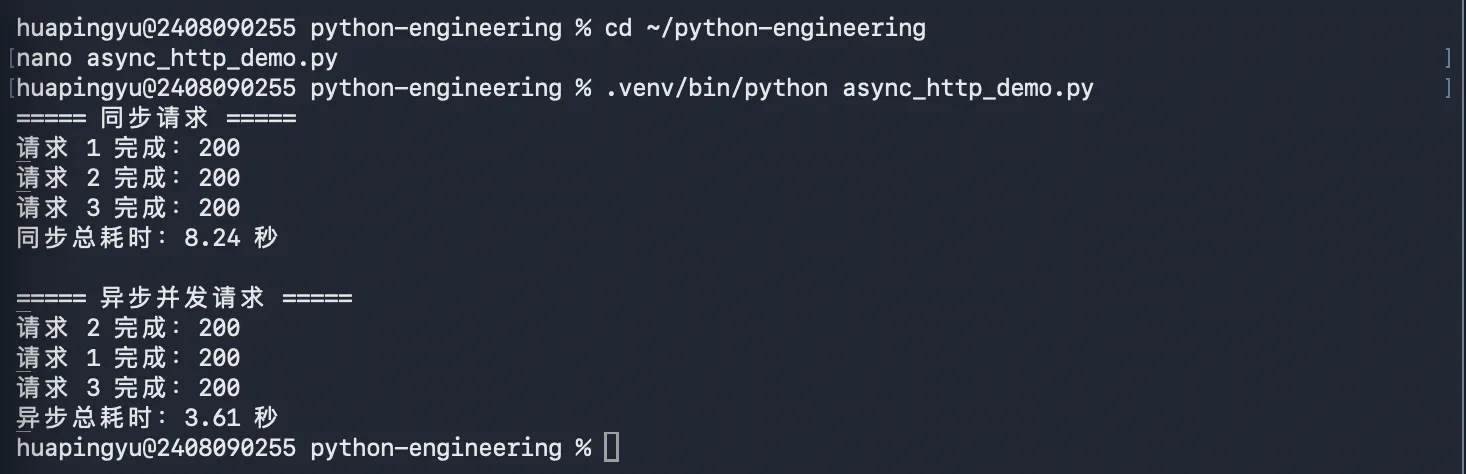
3. 运行程序
.venv/bin/python async_http_demo.py正常情况下,你会看到类似:
===== 同步请求 =====
请求 1 完成:200
请求 2 完成:200
请求 3 完成:200
同步总耗时:6.80 秒

===== 异步并发请求 =====
请求 1 完成:200
请求 3 完成:200
请求 2 完成:200
异步总耗时:2.60 秒
以上数字只是示例,实际耗时可能不同;异步请求的完成顺序也不固定。
4. Pydantic 数据建模与校验
这一阶段的目标是:能够使用 Pydantic 定义数据结构,自动校验外部数据,并将其应用到后续的 FastAPI 和 Agent 项目中。
1. Pydantic 是什么?
你之前学过 Java,可以把 Pydantic 的 BaseModel 暂时理解成:
Java 的 DTO + 数据类型校验 + 数据解析。
例如,我们开发一个 AI Agent 接口,需要接收用户发送的数据:
{
  "message": "你好",
  "temperature": 0.7,
  "max_tokens": 1000
}
如果只使用 Python 字典:
data = {
    "message": "你好",
    "temperature": 0.7,
    "max_tokens": 1000
}
Python 并不会自动确保这些字段的类型正确,也不会自动判断 temperature 是否在合法范围内。
Pydantic 就是用来解决这类问题的。
2. 先学习最核心的 BaseModel
我们先只学习三个知识点:
-
BaseModel:定义数据模型。 -
字段类型:
str、int、float等。 -
ValidationError:数据校验失败时的异常。
第一步:安装 Pydantic
进入之前的项目目录:
cd ~/python-engineering
uv add pydantic
我们继续使用已经建立好的 uv 项目环境。
第二步:创建练习文件
nano pydantic_demo.py输入以下代码:
from pydantic import BaseModel, ValidationError

class AgentRequest(BaseModel):
    message: str
    temperature: float
    max_tokens: int

# 正常数据
data = {
    "message": "你好",
    "temperature": 0.7,
    "max_tokens": 1000
}

try:
    request = AgentRequest(**data)

    print("模型对象:", request)
    print("用户消息:", request.message)
    print("温度参数:", request.temperature)
    print("最大 Token:", request.max_tokens)

except ValidationError as e:
    print("数据校验失败:")
    print(e)
运行:
.venv/bin/python pydantic_demo.py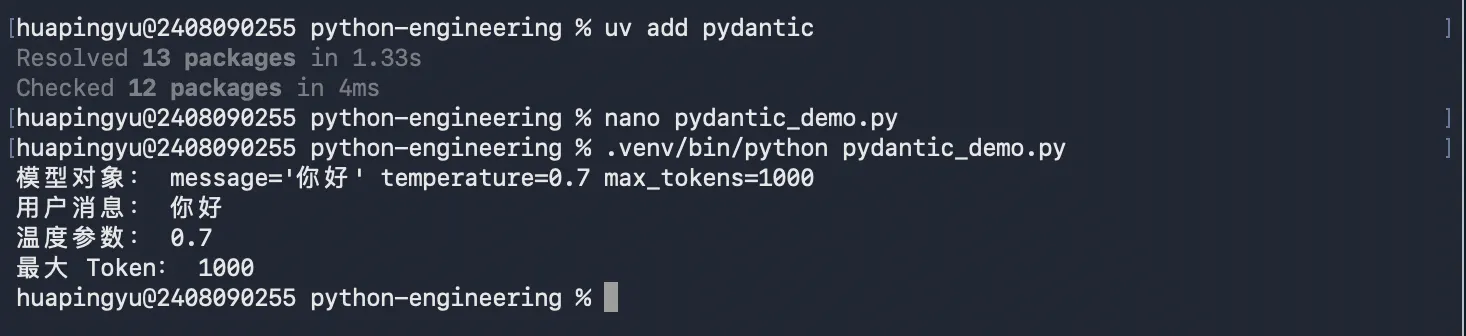
三、理解代码中的两个关键点
① class AgentRequest(BaseModel)
class AgentRequest(BaseModel):
    message: str
    temperature: float
    max_tokens: int
这里定义了一个 Pydantic 数据模型。
message: str 表示我们希望 message 是字符串,temperature: float 表示希望它是浮点数。
Pydantic 会在创建模型实例时进行校验,必要时还会尝试进行类型转换。
② AgentRequest(**data)
request = AgentRequest(**data)这里的 ** 是 Python 的字典解包语法。
它相当于:
request = AgentRequest(
    message="你好",
    temperature=0.7,
    max_tokens=1000
)
也就是将字典中的键值对作为关键字参数传入。
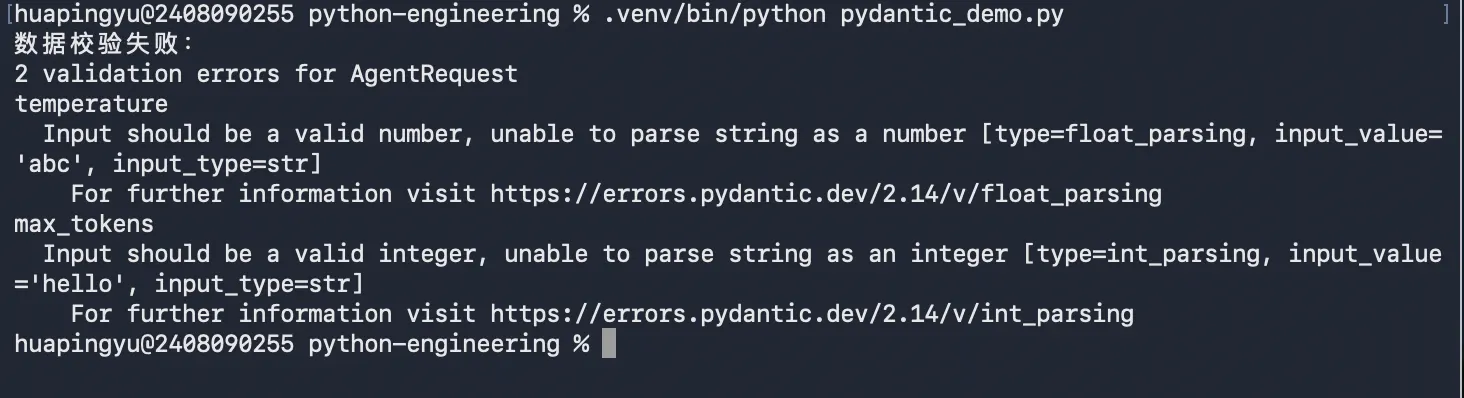
3. 动手练习:故意传入错误数据
第一次成功运行后,把 data 修改为:
data = {
    "message": "你好",
    "temperature": "abc",
    "max_tokens": "hello"
}
再运行一次,观察 ValidationError 输出。
4. Field() 字段约束与默认值
现在考虑一个新问题。
你之前定义的是:
class AgentRequest(BaseModel):
    message: str
    temperature: float
    max_tokens: int
假设用户传入:
data = {
    "message": "",
    "temperature": 100,
    "max_tokens": -50
}
这些数据的类型全部正确,但是对于一个 AI Agent 请求来说,显然不合理。
因此我们不仅要校验类型,还要校验数值范围、字符串长度。
这就需要 Field()。
5. 练习
第一步:修改模型
继续编辑 pydantic_demo.py,替换为以下代码:
from pydantic import BaseModel, Field, ValidationError


class AgentRequest(BaseModel):
    message: str = Field(min_length=1)
    temperature: float = Field(default=0.7, ge=0, le=2)
    max_tokens: int = Field(default=1000, gt=0, le=4096)


data = {
    "message": "你好"
}

try:
    request = AgentRequest(**data)
    print("模型对象:", request)

except ValidationError as e:
    print("数据校验失败:")
    print(e)
这段代码引入了几个新参数:
| 参数 | 含义 | 示例 |
|---|---|---|
default |
默认值 | default=0.7 |
min_length |
最小字符串长度 | min_length=1 |
ge |
大于等于 | ge=0 |
gt |
大于 | gt=0 |
le |
小于等于 | le=2 |
这里的 temperature 允许范围是 0~2,max_tokens 允许范围是 1~4096。这些是我们为练习设定的规则,不代表所有大模型 API 都采用相同限制。
第二步:运行
.venv/bin/python pydantic_demo.py
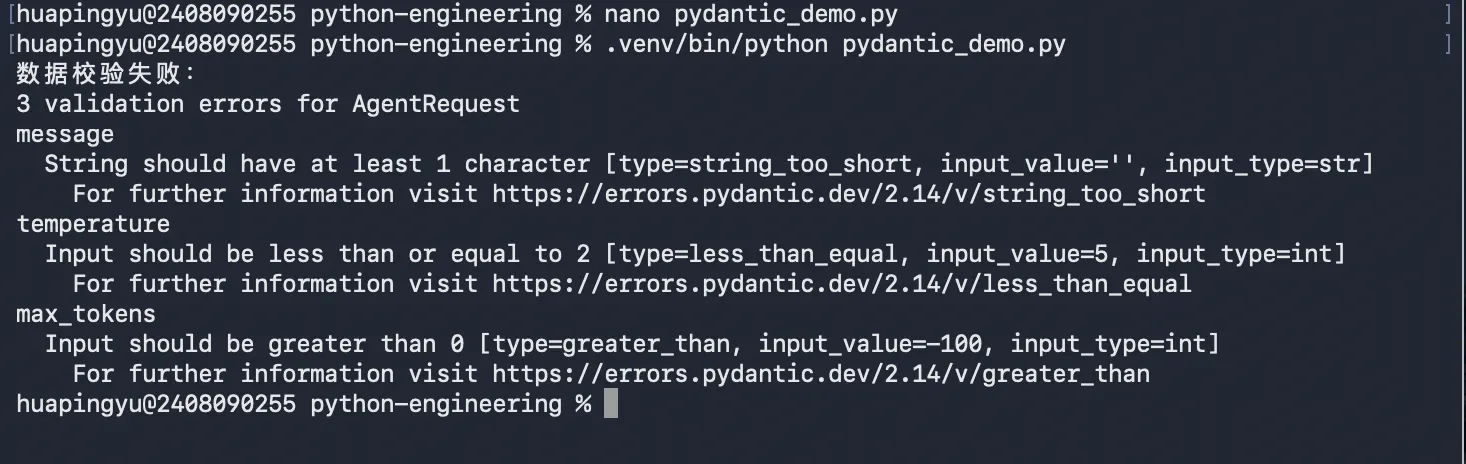
注意:我们没有传入 temperature 和 max_tokens,但 Pydantic 自动使用了默认值。
第三步:测试非法数据
将 data 修改为:
data = {
    "message": "",
    "temperature": 5,
    "max_tokens": -100
}
重新运行,观察三个字段分别出现什么错误。
6. 嵌套模型
1. 什么是嵌套模型?
假设我们开发一个 Agent,它接收的请求不再只有一条消息,而是包含用户信息和聊天记录:
{
  "user": {
    "id": 1,
    "name": "张三"
  },
  "messages": [
    {
      "role": "user",
      "content": "你好"
    },
    {
      "role": "assistant",
      "content": "你好,有什么可以帮你?"
    }
  ]
}
这里出现了两个特点:
-
user是一个嵌套对象。 -
messages是一个列表,里面包含多个对象。
Pydantic 可以让我们分别定义这些数据结构,再组合成完整模型。
2. 动手实现
创建新文件,保留之前的练习代码:
nano pydantic_nested.py输入:
from pydantic import BaseModel, Field


class User(BaseModel):
    id: int
    name: str


class Message(BaseModel):
    role: str
    content: str = Field(min_length=1)


class ChatRequest(BaseModel):
    user: User
    messages: list[Message]


data = {
    "user": {
        "id": 1,
        "name": "张三"
    },
    "messages": [
        {
            "role": "user",
            "content": "你好"
        },
        {
            "role": "assistant",
            "content": "你好,有什么可以帮你?"
        }
    ]
}


request = ChatRequest(**data)

print("用户姓名:", request.user.name)
print("第一条消息:", request.messages[0].content)
print("消息数量:", len(request.messages))
print("完整数据:", request.model_dump())
运行:
.venv/bin/python pydantic_nested.py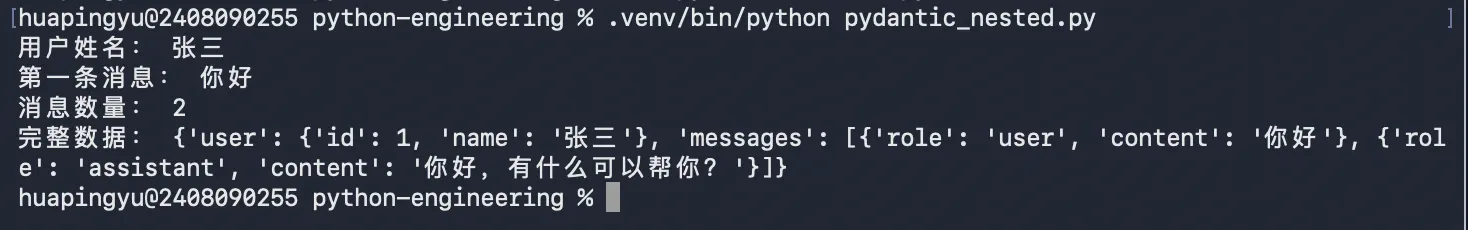
3. 理解三个关键知识点
① 模型可以作为另一个模型的字段类型
class ChatRequest(BaseModel):
    user: User
这表示 user 必须符合 User 模型的结构。
② list[Message] 表示列表中的每个元素都必须符合 Message 模型
messages: list[Message]Pydantic 会逐个校验列表中的消息。
③ model_dump() 将模型转换为 Python 字典
request.model_dump()它会将嵌套模型也转换成字典和列表,方便后续处理。
如果需要 JSON 字符串,则可以使用:
request.model_dump_json()7. 数据转换
-
序列化:将模型对象转换成字典、JSON 等便于传输或存储的数据。
-
反序列化:将 JSON 等数据解析为程序中的对象。在 Pydantic 中,这个过程通常还包含数据校验。
1. 三个常用方法
| 方法 | 作用 | 返回结果 |
|---|---|---|
model_dump() |
模型转字典 | dict |
model_dump_json() |
模型转 JSON 字符串 | str |
model_validate() |
从字典等数据校验并创建模型 | BaseModel 实例 |
2. 直接动手
在 ~/python-engineering 中创建:
nano pydantic_serialization.py复制以下代码:
from pydantic import BaseModel

class AgentRequest(BaseModel):
    message: str
    temperature: float = 0.7

# 1. 创建模型对象
request = AgentRequest(message="你好")

# 2. 序列化为字典
data = request.model_dump()
print("字典:", data)
print("类型:", type(data))

# 3. 序列化为 JSON 字符串
json_data = request.model_dump_json()
print("JSON:", json_data)
print("类型:", type(json_data))

# 4. 从字典重新创建模型
new_request = AgentRequest.model_validate(data)
print("重新创建:", new_request)
print("类型:", type(new_request))
运行:
.venv/bin/python pydantic_serialization.py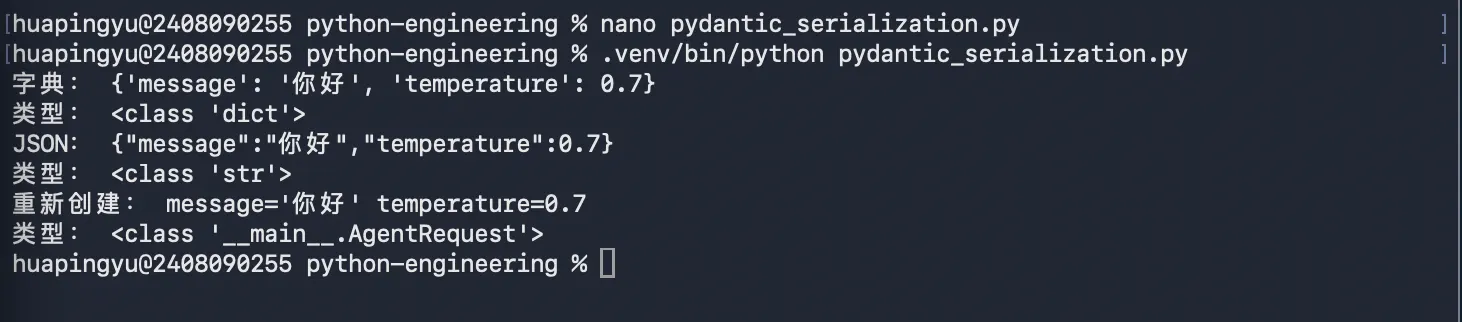
5. FastAPI Web 开发
未命名